


Quando pedimos a uma inteligência artificial para enviar uma mensagem, consultar um banco de dados ou criar uma tarefa, pode parecer que o próprio modelo entrou no sistema e executou a operação. Não foi exatamente isso que aconteceu.
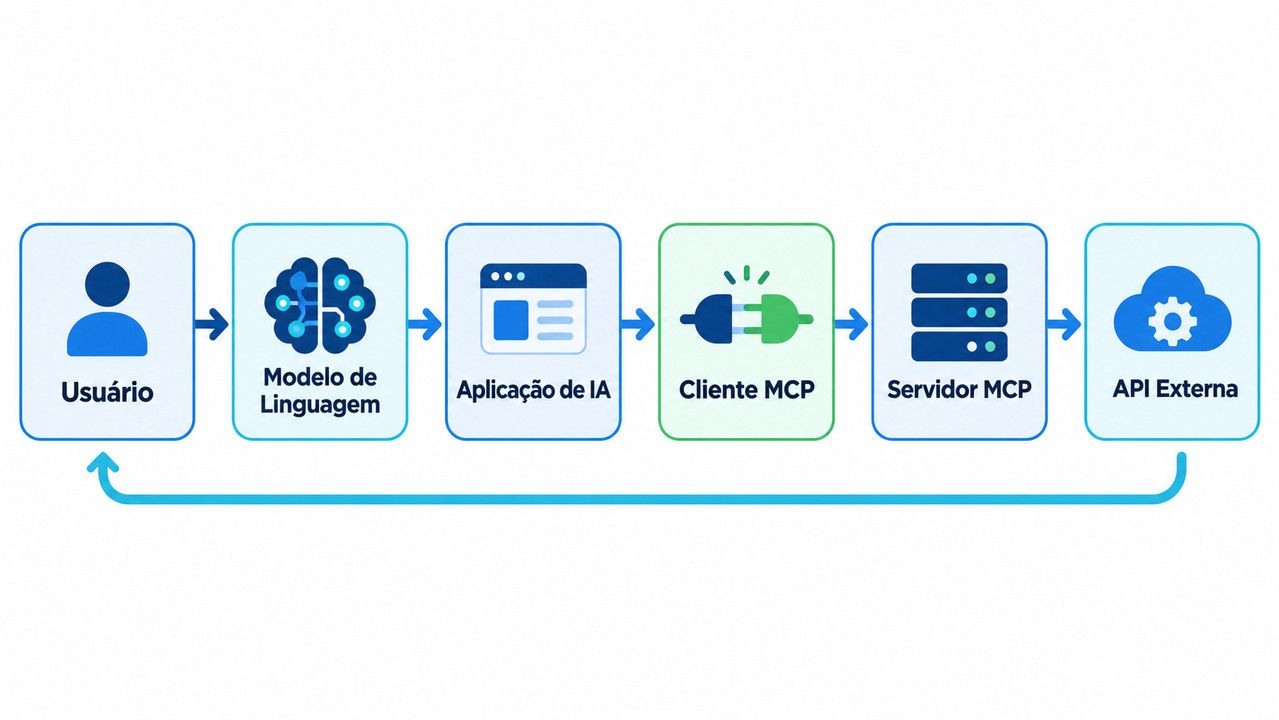
Um modelo de linguagem recebe informações e produz uma resposta. Essa resposta pode ser um texto comum, um trecho de código ou uma solicitação estruturada para que alguma ferramenta seja utilizada. Quem realmente faz a chamada de rede, acessa a API e manipula os dados é a aplicação que está ao redor do modelo.
Essa distinção parece um detalhe interno, mas ajuda a compreender quase tudo: como funcionam os agentes de IA, onde ficam as chaves de API, quem deve autorizar uma operação e qual problema o Model Context Protocol, o MCP, pretende resolver.
O MCP não concede acesso direto do modelo ao mundo exterior. Ele padroniza a conversa entre a aplicação de inteligência artificial e os sistemas capazes de realizar ações.
Antes do MCP, precisamos entender uma API
Uma API, ou Interface de Programação de Aplicações, define uma maneira organizada para que um programa solicite dados ou ações a outro programa.
Quando um aplicativo de previsão do tempo mostra a temperatura de uma cidade, ele não precisa manter estações meteorológicas próprias espalhadas pelo mundo. Pode enviar uma solicitação para a API de um serviço meteorológico. Essa API recebe a localidade, consulta seus dados e devolve uma resposta estruturada.
O processo pode ser parecido com este:
GET /weather?city=Belo-HorizonteA resposta poderia vir em JSON:
{
  "city": "Belo Horizonte",
  "temperature": 27,
  "condition": "parcialmente nublado"
}
O aplicativo conhece previamente o endereço da API, o método que deve usar, os parâmetros exigidos e o formato provável da resposta. Também precisa saber como se autenticar, quais erros podem ocorrer e quantas chamadas são permitidas em determinado período.
A API funciona como um contrato. De um lado existe o programa consumidor. Do outro, o serviço que possui os dados ou executa a operação. Se ambos respeitarem o contrato, conseguem conversar mesmo tendo sido desenvolvidos por equipes diferentes e usando tecnologias distintas.
Esse mecanismo não apareceu com a inteligência artificial. APIs já conectavam sites, aplicativos móveis, sistemas bancários, plataformas de pagamento, serviços de mapas, redes sociais e infraestruturas corporativas muito antes da popularização dos modelos generativos.
O novo problema surgiu quando começamos a querer que modelos de linguagem escolhessem e utilizassem essas operações de acordo com pedidos escritos de maneira natural.
O modelo não segura a chave nem abre a conexão
Um LLM não é, por si só, um programa convencional com acesso automático à internet, ao sistema operacional e às contas do usuário. O modelo recebe uma sequência de informações, processa padrões e gera uma continuação provável dentro do formato esperado.
Quando ele “decide usar uma ferramenta”, o que normalmente produz é uma solicitação estruturada. Algo semelhante a isto:
{
  "tool": "consultar_clima",
  "arguments": {
    "cidade": "Belo Horizonte"
  }
}
Isso ainda não é a chamada à API meteorológica. É uma saída do modelo dizendo à aplicação: “para responder ao usuário, acredito que esta ferramenta deve ser chamada com estes argumentos”.
A aplicação hospedeira recebe a solicitação. Ela pode validar os argumentos, verificar as permissões, pedir confirmação ao usuário e somente então executar a ferramenta. Depois, o resultado volta para a aplicação e pode ser enviado ao modelo para que ele produza uma resposta compreensível.
O fluxo completo seria mais ou menos assim:
- O usuário pede a previsão do tempo.
- A aplicação envia o pedido e a descrição das ferramentas ao modelo.
- O modelo solicita o uso de
consultar_clima. - A aplicação avalia e executa a solicitação.
- A ferramenta consulta a API meteorológica.
- A API devolve os dados.
- A aplicação entrega o resultado ao modelo.
- O modelo redige a resposta ao usuário.
Em alguns produtos, essas etapas acontecem tão rapidamente que parecem uma única ação. Internamente, são operações diferentes.
Isso também mostra por que não faz sentido entregar indiscriminadamente chaves secretas ao modelo. Ele não precisa conhecer a chave. Precisa apenas conhecer o nome da ferramenta, sua finalidade e os argumentos aceitos. A credencial pode permanecer no componente responsável pela execução.
Uma integração é administrável. Cinquenta já são outra história
Imagine uma empresa desenvolvendo um assistente interno. No início, ele precisa apenas consultar mensagens no Slack. A equipe cria uma integração, configura a autenticação e descreve algumas funções para o modelo.
Logo aparece a necessidade de consultar tarefas no Jira. Depois vêm Gmail, Google Calendar, GitHub, Salesforce, bancos de dados internos, armazenamento de arquivos, sistema financeiro e plataforma de atendimento.
Cada serviço possui características próprias:
- endpoints diferentes;
- métodos de autenticação diferentes;
- formatos de erro diferentes;
- políticas de limite de uso;
- estruturas de dados específicas;
- versões que mudam com o tempo;
- permissões que variam entre usuários.
Ainda seria possível criar manualmente uma camada de funções para cada serviço. O problema cresce quando a organização não possui apenas uma aplicação de IA.
Talvez exista um chatbot para atendimento, um assistente dentro da IDE, um agente para análise de documentos e uma ferramenta interna para automação administrativa. Se cada aplicação implementar separadamente suas conexões com Slack, Jira, Gmail e outros serviços, a equipe começa a repetir o mesmo trabalho.
Uma atualização na API do Jira precisa ser corrigida em várias integrações. Uma mudança no fluxo de autenticação do Gmail quebra diferentes aplicações. Uma nova regra de acesso precisa ser reproduzida em todos os lugares. Cada conector pode desenvolver seu próprio formato para representar ferramentas e resultados.
É a conhecida explosão combinatória: vários modelos, várias aplicações e vários serviços conectados de maneiras particulares.
A dificuldade não está apenas em escrever a primeira versão. Manutenção, auditoria, testes, observabilidade e segurança costumam consumir muito mais tempo durante a vida útil do sistema.
O MCP cria uma camada comum
O Model Context Protocol foi criado para padronizar a conexão entre aplicações de inteligência artificial e sistemas externos. Ele define uma arquitetura cliente-servidor e uma forma comum de expor ferramentas, recursos e outros tipos de contexto.
Segundo a documentação oficial, os três participantes centrais são:
- MCP Host: a aplicação de IA com a qual o usuário interage;
- MCP Client: o componente interno responsável por se comunicar com determinado servidor;
- MCP Server: o programa que disponibiliza ferramentas, recursos ou capacidades.
O host pode ser um chatbot, uma IDE ou um agente corporativo. Dentro dele, um cliente MCP conversa com um servidor específico. Quando vários servidores são utilizados, o host normalmente administra diferentes clientes e reúne as capacidades encontradas. Documentação da arquitetura MCP.
O servidor MCP fica próximo do serviço real. Ele pode conversar com a API do Jira, acessar o sistema de arquivos, consultar um banco PostgreSQL ou utilizar a API do Gmail. Para a aplicação de IA, essas diferenças internas ficam escondidas atrás de uma interface padronizada.
Um servidor do Jira poderia expor ferramentas como:
buscar_tarefa
criar_tarefa
adicionar_comentario
alterar_status
Cada ferramenta teria uma descrição e um esquema indicando os argumentos aceitos. buscar_tarefa talvez precise apenas do identificador. criar_tarefa exigiria projeto, título, descrição e tipo. alterar_status receberia o identificador da tarefa e o novo estado.
O cliente não precisa estudar toda a API original do Jira para descobrir essas operações. Ele consulta o servidor MCP, obtém as ferramentas disponíveis e apresenta as definições relevantes ao modelo.
A especificação inclui operações como tools/list, usada para listar ferramentas, e tools/call, usada para solicitar sua execução. Cada ferramenta pode informar nome, descrição e um esquema de entrada. Especificação de ferramentas MCP.
Essa padronização favorece o reaproveitamento. Em princípio, um servidor MCP bem implementado pode atender diferentes aplicações compatíveis sem que cada uma desenvolva novamente toda a integração.
O MCP não substitui a API existente
Esta é provavelmente a confusão mais comum.
Se uma empresa já disponibiliza uma API para criar tarefas, o servidor MCP pode utilizar essa API internamente. O serviço continua recebendo requisições HTTP, validando tokens e devolvendo respostas. O MCP fica acima dessa comunicação.
O fluxo poderia ser representado assim:
Usuário
   ↓
Aplicação de IA
   ↓
Modelo de linguagem
   ↓
MCP Client
   ↓
MCP Server
   ↓
API existente
   ↓
Serviço externo
O servidor MCP atua como adaptador. Ele recebe uma chamada padronizada, converte os argumentos para o formato esperado pela API, executa a requisição e reorganiza o resultado.
O contrário também é possível. Um servidor MCP pode acessar diretamente um banco de dados, executar um programa local ou ler arquivos sem existir uma API HTTP no meio. O protocolo não obriga o servidor a utilizar uma API tradicional.
Mesmo quando utiliza HTTP, MCP e HTTP não são concorrentes. HTTP é um mecanismo de transporte amplamente usado na comunicação entre sistemas. O MCP define capacidades e mensagens voltadas à integração de aplicações de IA. O próprio MCP pode usar Streamable HTTP como transporte ou funcionar localmente por stdio.
Falar em “MCP contra APIs” é útil apenas como comparação didática. Tecnicamente, o cenário mais comum é “MCP usando APIs”.
Abordagem direta: entregar a documentação da API ao agente
Uma maneira aparentemente simples de conectar um agente a um serviço seria fornecer a documentação completa da API e deixar que ele descubra como fazer as chamadas.
Suponha que o usuário peça:
Crie no Jira uma tarefa para investigar o erro de autenticação do aplicativo.
O agente recebe centenas de páginas de documentação explicando endpoints, cabeçalhos, autenticação, objetos, paginação, códigos de erro e versões. Ele precisa localizar o endpoint correto, montar a requisição e interpretar a resposta.
A chamada talvez seja parecida com:
POST /rest/api/3/issue
Authorization: Bearer TOKEN
Content-Type: application/json
E o corpo:
{
  "fields": {
    "project": {
      "key": "APP"
    },
    "summary": "Investigar erro de autenticação",
    "issuetype": {
      "name": "Task"
    }
  }
}
Esse caminho pode funcionar quando o agente possui um ambiente de execução controlado, acesso a um cliente HTTP e mecanismos para proteger as credenciais. Modelos modernos conseguem interpretar documentação técnica e montar requisições com qualidade razoável.
Só que alguns problemas aparecem.
Primeiro, a documentação bruta contém muito mais informação do que a tarefa exige. O agente precisa de um endpoint, mas recebe descrições de dezenas ou centenas. Essa carga ocupa espaço no contexto e pode dificultar a escolha.
Segundo, documentação é escrita para explicar uma API a desenvolvedores. Ela pode conter exemplos antigos, detalhes opcionais e várias maneiras de realizar a mesma operação. O modelo precisa transformar tudo isso em uma decisão executável.
Terceiro, dar acesso genérico a um cliente HTTP pode permitir chamadas que a aplicação não pretendia oferecer. Se o agente conhece toda a API e possui uma credencial poderosa, a fronteira de ação fica ampla demais.
Há também o tratamento de erros. A API pode devolver uma estrutura extensa, códigos específicos ou mensagens pouco úteis para o modelo. A aplicação terá de interpretar esses casos ou confiar que o modelo entenda corretamente cada variação.
Ainda assim, a abordagem direta não é absurda. Para uma integração pequena, experimental ou muito específica, ela pode ser suficiente. Criar e manter um servidor MCP completo talvez acrescente trabalho sem oferecer benefício proporcional.
Com MCP, o agente recebe uma ferramenta estreita
Na abordagem com MCP, o modelo não precisa receber toda a documentação do Jira. O servidor pode expor uma ferramenta específica:
{
  "name": "criar_tarefa",
  "description": "Cria uma nova tarefa em um projeto autorizado do Jira",
  "inputSchema": {
    "type": "object",
    "properties": {
      "projeto": {
        "type": "string"
      },
      "titulo": {
        "type": "string"
      },
      "descricao": {
        "type": "string"
      }
    },
    "required": [
      "projeto",
      "titulo"
    ]
  }
}
Diante do pedido do usuário, o modelo solicita:
{
  "name": "criar_tarefa",
  "arguments": {
    "projeto": "APP",
    "titulo": "Investigar erro de autenticação",
    "descricao": "Verificar falhas relatadas durante o login no aplicativo."
  }
}
O servidor MCP transforma esses campos na estrutura esperada pela API do Jira. Pode acrescentar valores internos, selecionar o endpoint correto, verificar se o projeto está autorizado e traduzir erros técnicos para mensagens mais úteis.
A diferença está na fronteira oferecida ao modelo.
Na integração direta, o agente recebe uma documentação extensa e capacidade genérica para construir chamadas. Com MCP, ele recebe uma operação delimitada, descrita de maneira estruturada. O servidor absorve boa parte das particularidades da API.
Isso reduz a chance de o modelo inventar um endpoint ou usar um campo incompatível. Não elimina erros. Um esquema mal escrito ou uma descrição ambígua continua confundindo o modelo.
Também não elimina o desenvolvimento. Alguém ainda precisa criar o servidor, mapear os campos, implementar autenticação, tratar erros e acompanhar as mudanças da API original. O ganho aparece quando essa integração pode ser reutilizada por várias aplicações ou quando se deseja uma fronteira mais estável entre o modelo e o serviço.
Uma comparação sem propaganda
As duas abordagens resolvem necessidades parecidas, mas distribuem a complexidade em lugares diferentes.
Documentação da API e execução direta
O modelo recebe instruções sobre a API e produz chamadas ou código para utilizá-la.
Essa estratégia oferece flexibilidade. O agente pode acessar funcionalidades que não foram antecipadas na criação de uma ferramenta específica. Para desenvolvedores, ambientes de teste e automações pontuais, isso pode ser muito útil.
O custo é deixar mais interpretação nas mãos do modelo. É preciso controlar o executor HTTP, limitar destinos, retirar credenciais do contexto e validar todas as chamadas. A documentação também consome tokens e pode precisar ser atualizada ou consultada a cada tarefa.
Servidor MCP
O modelo recebe ferramentas selecionadas, com descrições e esquemas de entrada conhecidos. O servidor conversa com a API e devolve resultados em formatos previstos.
Essa estratégia melhora padronização e reaproveitamento. Diferentes hosts compatíveis podem utilizar o mesmo servidor. Permissões e regras de negócio podem ficar concentradas em uma camada própria.
O custo é construir mais um componente de software. O servidor precisa ser instalado ou hospedado, atualizado, testado e auditado. Em ambientes grandes, também será necessário gerenciar versões, catálogos, políticas e observabilidade.
Não existe uma vitória automática do MCP em todos os cenários. Às vezes, um pequeno wrapper interno com três funções é tudo o que o projeto precisa. Em outros casos, manter integrações particulares em cinco aplicações diferentes seria desperdício claro.
Descoberta não significa liberdade total
Uma vantagem do MCP é permitir que o cliente consulte quais ferramentas determinado servidor oferece. A aplicação não precisa manter uma lista completamente fixa no código.
Esse mecanismo é chamado de descoberta. O cliente pode listar ferramentas, recursos ou prompts e atualizar seu catálogo quando as capacidades mudam. Para o modelo, isso significa receber informações sobre o que pode ser utilizado naquele momento.
Mas a descoberta possui limites definidos pela aplicação.
O modelo não procura servidores desconhecidos livremente pela internet. O host se conecta aos servidores configurados e decide quais capacidades serão disponibilizadas. As ferramentas retornadas também podem variar segundo a autorização apresentada pelo usuário.
Essa é uma distinção importante. Descoberta dinâmica não deve significar acesso espontâneo. Significa que, depois de uma conexão confiável ser estabelecida, o cliente consegue perguntar ao servidor quais operações estão disponíveis.
O custo escondido das ferramentas no contexto
Toda ferramenta apresentada ao modelo ocupa espaço.
Nome, descrição, parâmetros, tipos, campos obrigatórios e instruções de uso precisam ser incluídos no contexto ou disponibilizados por algum mecanismo de descoberta. Com cinco ferramentas pequenas, esse custo quase não chama atenção. Com centenas de ferramentas vindas de vários servidores, torna-se significativo.
A documentação oficial do MCP reconhece esse problema. Carregar antecipadamente todas as definições pode desperdiçar tokens, aumentar a latência e prejudicar o desempenho do modelo. Uma das estratégias sugeridas é a descoberta progressiva: o host mantém um catálogo, oferece uma ferramenta de busca e injeta no contexto apenas as definições necessárias para aquela tarefa. Boas práticas para clientes MCP.
Isso corrige uma percepção exagerada de que o MCP sempre economiza contexto. Um servidor com ferramentas bem desenhadas pode evitar que a documentação completa de uma API seja enviada ao modelo. Mas um host que carrega milhares de esquemas em todas as conversas pode gastar uma quantidade enorme de tokens.
Também há o tamanho dos resultados. Uma ferramenta de banco de dados capaz de devolver cem mil registros não deveria colocar todos eles diretamente no contexto do modelo. O servidor ou a aplicação pode paginar, filtrar, agregar ou guardar os dados fora do contexto e fornecer somente a parte relevante.
O MCP organiza o caminho. Não reduz dados por conta própria.
Onde devem ficar as chaves de API
Em uma integração bem projetada, uma chave de API não deve aparecer no prompt, no histórico da conversa ou na saída visível do modelo.
Na abordagem direta, isso pode ser obtido por meio de um executor controlado. O modelo pede uma operação e a aplicação acrescenta a credencial somente durante a chamada de rede.
Com MCP, a credencial pode permanecer no servidor ou em um mecanismo de autorização associado a ele. Para servidores locais baseados em stdio, credenciais podem ser recuperadas do ambiente. Servidores remotos que usam transporte HTTP podem adotar o modelo de autorização definido pelo protocolo, seguindo convenções de OAuth. Especificação de autorização MCP.
Isso impede que o modelo leia diretamente o segredo, mas esconder a chave não basta.
Se uma ferramenta chamada executar_sql aceitar qualquer comando e usar uma conta administrativa do banco, o modelo não precisa conhecer a senha para causar danos. Basta solicitar uma operação perigosa.
A segurança real depende de controles como:
- menor privilégio;
- separação entre leitura e escrita;
- validação dos argumentos;
- confirmação para operações sensíveis;
- restrição por usuário e por recurso;
- registros de auditoria;
- proteção contra vazamento de tokens;
- revisão da procedência do servidor MCP.
O protocolo possui recomendações de segurança, mas não transforma automaticamente uma integração mal configurada em uma integração segura. A documentação oficial aborda riscos como passagem indevida de tokens, servidores proxy atuando como representantes confusos e comprometimento de servidores locais. Boas práticas de segurança do MCP.
Instalar um servidor MCP desconhecido merece o mesmo cuidado que instalar qualquer programa com acesso a arquivos, contas e serviços. Talvez até mais, porque sua finalidade é justamente executar ações em nome do usuário.
Quando a integração direta faz sentido
Usar uma API diretamente pode ser a melhor escolha quando existe apenas uma integração pequena e estável. Se uma aplicação interna consulta um único endpoint, criar um servidor separado pode aumentar a arquitetura sem reduzir trabalho de maneira relevante.
A abordagem direta também é interessante quando a aplicação exige controle muito específico sobre latência, tratamento de erros e fluxo de execução. Em vez de expor ferramentas genéricas, a equipe implementa exatamente as operações necessárias.
Protótipos entram nessa categoria. Antes de transformar uma ideia em infraestrutura reutilizável, uma função simples pode mostrar se o fluxo realmente possui valor.
Outro caso envolve APIs que mudam com frequência ou recursos ainda experimentais. Uma camada MCP pode esconder parte dessa instabilidade, mas alguém continuará atualizando o adaptador. Se apenas uma aplicação utiliza o serviço, talvez seja mais simples manter o código próximo dela.
Quando o MCP começa a valer a pena
O MCP se torna mais atraente quando uma integração precisa ser usada por vários hosts, agentes ou aplicações. O servidor concentra a comunicação com o serviço externo, enquanto clientes compatíveis reutilizam a mesma interface.
Ele também ajuda quando o conjunto de ferramentas muda dinamicamente. O cliente consegue consultar capacidades em vez de depender de uma lista escrita manualmente e distribuída em diferentes aplicações.
Em ambientes corporativos, o protocolo pode servir como uma fronteira de governança. A empresa expõe operações aprovadas, limita parâmetros, aplica autenticação e registra chamadas. Isso é mais administrável do que entregar documentação completa e credenciais amplas a cada agente.
Existe ainda a portabilidade. Se uma equipe trocar o modelo ou a aplicação hospedeira, um servidor baseado em um padrão aberto tem mais chance de ser reutilizado. Essa é uma promessa arquitetural, não uma garantia absoluta: clientes podem oferecer níveis diferentes de compatibilidade e implementar interfaces próprias ao redor do protocolo.
A arquitetura híbrida tende a ser a mais realista
Na prática, a divisão entre integração direta e MCP dificilmente será total.
Um servidor MCP frequentemente chama APIs tradicionais. Algumas operações permanecerão implementadas diretamente dentro da aplicação. Ferramentas genéricas podem coexistir com funções extremamente especializadas. Um agente de desenvolvimento talvez consulte documentação bruta para criar código, enquanto um agente administrativo utiliza apenas ações MCP rigorosamente controladas.
A pergunta correta não é se APIs devem ser abandonadas. Elas continuam sendo fundamentais.
A pergunta é onde faz sentido colocar a camada que descreve ferramentas para o modelo, protege credenciais, valida ações e transforma respostas de serviços em resultados que uma aplicação de IA consegue administrar.
Para projetos pequenos, essa camada pode ser uma função local. Em ecossistemas maiores, um protocolo compartilhado começa a fazer diferença.
O MCP não torna o modelo capaz de conversar diretamente com qualquer sistema. Ele formaliza a conversa entre softwares que já existia ao redor do modelo. Parece menos espetacular quando explicado dessa maneira, mas é justamente aí que está seu valor.
Modelos mudam. APIs mudam. Aplicações também. Uma fronteira comum não impede essas mudanças, só evita que todas elas precisem ser reconstruídas umas dentro das outras.


0 comments:
Postar um comentário