Mostrando postagens com marcador engenharia. Mostrar todas as postagens

Nokia: da fábrica de papel ao domínio dos telefones celulares

Muito antes de o nome Nokia aparecer na tela de um telefone celular, ele estava associado a papel, madeira, borracha, cabos elétricos e geração de energia. A empresa atravessou diferentes revoluções industriais até se transformar em uma das marcas tecnológicas mais reconhecidas do planeta.
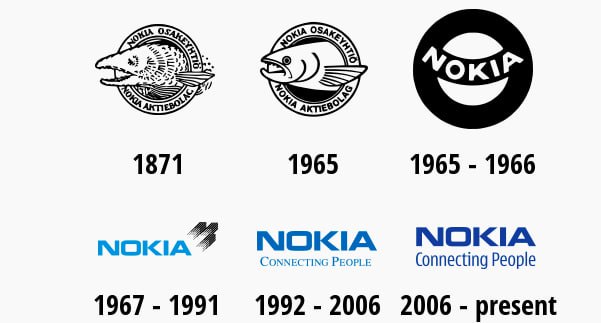
Antigo logotipo da Nokia com um peixe, utilizado durante a fase industrial da empresa
Um dos primeiros emblemas associados à Nokia trazia a figura de um peixe, referência ao rio Nokianvirta e às origens industriais da empresa na Finlândia.

Para quem viveu as décadas de 1990 e 2000, a palavra Nokia quase sempre desperta a mesma lembrança: um telefone compacto, resistente, com bateria removível e um teclado físico que permitia escrever mensagens sem olhar para a tela. Em muitos lugares, a marca se tornou praticamente sinônimo de telefone celular.

Só que essa é apenas uma parte de uma história iniciada no século XIX, antes mesmo de a Finlândia existir como país independente.

A Nokia nasceu antes da própria Finlândia

A origem da Nokia remonta a 12 de maio de 1865, quando o engenheiro de minas finlandês Fredrik Idestam recebeu autorização para instalar uma fábrica de pasta de madeira às margens das corredeiras de Tammerkoski, na cidade de Tampere.

Naquele período, a região fazia parte do Grão-Ducado da Finlândia, território autônomo ligado ao Império Russo. A independência finlandesa só seria declarada em 1917. Isso significa que a empresa que viria a se tornar a Nokia é mais antiga que o próprio Estado finlandês moderno.

A primeira fábrica não ficava propriamente na cidade de Nokia, como algumas versões resumidas da história afirmam. Ela foi construída em Tampere. Em 1868, Idestam instalou uma segunda unidade perto da pequena cidade de Nokia, cerca de 15 quilômetros a oeste, onde o rio Nokianvirta oferecia melhores condições para o aproveitamento da energia hidráulica.

Em 1871, Idestam e o político e empresário Leo Mechelin organizaram formalmente o negócio como uma companhia chamada Nokia Ab — “Ab” era a abreviação sueca de Aktiebolag, equivalente a uma sociedade por ações. A empresa recebeu o nome da localidade onde estava sua segunda fábrica, cuja identidade também estava ligada ao rio Nokianvirta.

Os primeiros emblemas da Nokia não tinham as letras azuis que se tornariam famosas um século depois. Um deles mostrava um peixe, geralmente interpretado como uma referência ao salmão ou a outro peixe encontrado no rio. O desenho carregava o nome da empresa em finlandês e sueco, acompanhando a realidade linguística da região.

Não era ainda uma marca de tecnologia. Era uma empresa de papel e processamento de madeira.

Papel, borracha e cabos não eram inicialmente a mesma empresa

A trajetória industrial da Nokia costuma ser resumida como se a companhia tivesse decidido, sozinha, começar a fabricar papel, depois botas de borracha, cabos, televisores e telefones. A história real foi um pouco mais complicada.

A Nokia Ab começou ligada à produção de celulose e papel. Com o tempo, também passou a atuar na geração de eletricidade. Outras duas empresas finlandesas tiveram participação decisiva na formação do grupo que conheceríamos mais tarde: a Finnish Rubber Works, fundada em 1898, e a Finnish Cable Works, criada em 1912.

A Finnish Rubber Works produzia botas, pneus, mangueiras e vários artigos de borracha. A Finnish Cable Works fabricava cabos para redes de eletricidade, telégrafo e telefone. Eram empresas juridicamente separadas, embora seus negócios e proprietários tenham se aproximado ao longo do século XX.

Depois da Primeira Guerra Mundial, a Nokia Ab enfrentou dificuldades financeiras. A Finnish Rubber Works adquiriu participação na empresa, interessada principalmente em garantir energia para suas operações. Mais tarde, também assumiu o controle da Finnish Cable Works.

As três companhias mantiveram estruturas formais distintas durante décadas. A fusão definitiva ocorreu apenas em 1967, quando Nokia Ab, Finnish Rubber Works e Finnish Cable Works deram origem à moderna Nokia Corporation.

Esse detalhe muda um pouco a narrativa. A Nokia não passou linearmente de uma fábrica de papel para uma indústria de borracha e, depois, para uma fabricante de eletrônicos. O que aconteceu foi a formação gradual de um conglomerado industrial, reunindo negócios diferentes sob uma mesma organização.

Era uma Nokia muito diferente daquela que dominaria o mercado de celulares. O grupo fabricava papel, pneus, botas, cabos, televisores, equipamentos eletrônicos, sistemas de comunicação e até produtos destinados ao setor militar. A diversidade ajudava a empresa a sobreviver às mudanças econômicas, mas também criava uma estrutura pesada e difícil de administrar.

A entrada no mundo das telecomunicações

A aproximação com as telecomunicações aconteceu principalmente por meio da Finnish Cable Works. A fabricação de cabos já colocava a empresa em contato com redes telefônicas, transmissão elétrica e infraestrutura de comunicação.

Durante a década de 1960, o grupo começou a desenvolver equipamentos eletrônicos e sistemas de radiocomunicação. Uma divisão de eletrônica havia sido criada dentro da companhia de cabos, trabalhando com transmissão de dados, radiotelefones e dispositivos destinados a instituições públicas, forças de segurança e serviços de emergência.

Algumas cronologias atribuem ao engenheiro Kurt Wikstedt e à equipe de eletrônica da Nokia a criação de um radiotelefone em 1963 e de um modem de dados por rádio em 1965. Esses aparelhos, porém, não devem ser confundidos com um celular moderno. Eram equipamentos profissionais de comunicação sem fio, normalmente grandes e destinados a veículos ou instalações especializadas.

O desenvolvimento tinha uma lógica industrial. A Finlândia possuía grandes áreas pouco povoadas, longas distâncias e condições climáticas severas. Construir comunicação confiável nesse território era uma necessidade prática, não apenas uma aposta em um futuro mercado de consumo.

Ainda não existia o conceito de carregar no bolso um aparelho conectado permanentemente a uma rede. Os radiotelefones eram caros, pesados e dependiam de infraestrutura limitada. Muitos precisavam ser instalados em automóveis porque o conjunto de transmissão e a bateria ocupava espaço demais para ser transportado confortavelmente.

Mesmo assim, foi nessa fase que a Nokia acumulou experiência em rádio, antenas, modulação, redes e miniaturização. A transformação não aconteceu de repente nos anos 1990. Ela vinha sendo preparada havia décadas.

Os sistemas nórdicos abriram o caminho

Antes do GSM, os países nórdicos desenvolveram o padrão NMT — Nordic Mobile Telephone. A proposta era criar uma rede celular analógica compatível entre Finlândia, Suécia, Noruega e Dinamarca.

Essa compatibilidade era importante. Em outros lugares, cada país ou operadora adotava soluções próprias, dificultando o uso de um aparelho fora de sua região de origem. O NMT mostrou que sistemas móveis poderiam ser planejados de maneira cooperativa e ultrapassar fronteiras nacionais.

Em 1979, Nokia e a fabricante finlandesa de eletrônicos Salora criaram uma parceria para desenvolver equipamentos de radiotelefonia. A operação daria origem à Mobira, nome que apareceria em alguns dos primeiros telefones móveis comercializados pela companhia.

O Mobira Senator, apresentado em 1982, era um telefone para automóveis que pesava aproximadamente dez quilos. Era “móvel” porque podia acompanhar o veículo, não porque alguém pudesse colocá-lo no bolso e sair caminhando.

Cinco anos depois surgiu um aparelho muito mais interessante.

Mobira Cityman: o telefone que parecia pequeno em 1987

Em 1987, a Nokia-Mobira apresentou o Mobira Cityman, produzido em versões compatíveis com diferentes redes analógicas. O Cityman 900, destinado à rede NMT de 900 MHz, tornou-se o mais conhecido.

Ele pesava cerca de 760 gramas. Para os padrões atuais, seria um telefone enorme e desconfortável. Na época, foi apresentado como um aparelho compacto, capaz de ser carregado com uma mão e usado longe de um automóvel.

As dimensões faziam sentido diante do que existia anteriormente. Um equipamento de dez quilos havia sido reduzido a menos de um quilo. A bateria oferecia por volta de 50 minutos de conversação e aproximadamente 14 horas em espera, dependendo das condições da rede e do estado da bateria.

O preço era igualmente pesado. O Cityman 900 custava cerca de 24 mil marcos finlandeses, valor equivalente a vários milhares de euros quando ajustado para períodos mais recentes. Era um símbolo de poder econômico, destinado a executivos, autoridades e pessoas que realmente precisavam estar acessíveis fora do escritório.

O aparelho ganhou projeção internacional em outubro de 1989, quando o líder soviético Mikhail Gorbachev utilizou um Cityman durante uma visita a Helsinque para fazer uma ligação a Moscou. Na Finlândia, o telefone passou a ser chamado informalmente de Gorba, apelido derivado do sobrenome de Gorbachev.

A imagem tinha força. O chefe da União Soviética usando um telefone finlandês portátil sugeria que a comunicação móvel estava deixando de ser uma experiência de laboratório.

Só ainda custava caro demais para quase todo mundo.

O GSM não foi criado por duas empresas finlandesas

Outra simplificação comum diz que o padrão GSM foi desenvolvido pela Tampere Telephone Company e pela Helsinki Telephone Company. Essas empresas tiveram participação relevante na implantação da primeira rede comercial, mas não foram responsáveis, sozinhas, pela criação do padrão.

O GSM nasceu de um esforço europeu de padronização.

Em 1982, a Conferência Europeia das Administrações de Correios e Telecomunicações, conhecida pela sigla CEPT, criou o grupo Groupe Spécial Mobile. A missão era desenvolver uma especificação digital comum para as redes celulares europeias.

Representantes de governos, operadoras, fabricantes e organizações técnicas de vários países participaram desse processo. França, Alemanha Ocidental, Reino Unido, Itália e os países nórdicos tiveram papéis importantes. Em 1987, representantes de 13 países assinaram um memorando comprometendo-se com a implantação do sistema. A responsabilidade técnica acabaria sendo transferida para o recém-criado European Telecommunications Standards Institute, o ETSI, em 1989.

A Tampere Telephone Company e a Helsinki Telephone Company participaram de outro ponto decisivo. Junto de várias operadoras telefônicas locais, ajudaram a formar a Radiolinja, que pretendia construir uma rede celular digital capaz de concorrer com a operadora estatal Telecom Finland.

A Radiolinja adquiriu infraestrutura da Nokia, e a rede foi construída com tecnologia fornecida pela Nokia e pela Siemens. Era uma aposta arriscada. O GSM ainda enfrentava problemas técnicos, as especificações estavam em desenvolvimento e o mercado continuava dominado por redes analógicas.

A escolha acabou definindo o futuro da Nokia.

A primeira ligação oficial em uma rede GSM

Em 1º de julho de 1991, o então primeiro-ministro finlandês Harri Holkeri realizou aquela que ficou registrada como a primeira ligação oficial em uma rede GSM comercial. Ele estava em Helsinque e conversou com Kaarina Suonio, vice-prefeita de Tampere.

A chamada durou pouco mais de três minutos e foi realizada por meio de uma rede da Radiolinja, construída com equipamentos da Nokia e da Siemens. O telefone utilizado era um protótipo da Nokia. A própria companhia relembra o episódio em seu registro dos 30 anos da primeira ligação oficial GSM.

Há uma pequena nuance histórica: engenheiros realizaram chamadas de teste antes da cerimônia pública. A ligação de Holkeri não foi necessariamente a primeira transmissão técnica entre dois aparelhos GSM, mas foi a primeira chamada oficial associada ao lançamento comercial da rede.

Isso não diminui seu significado. Aquele momento mostrou que um sistema digital europeu havia saído dos documentos e laboratórios para funcionar em uma rede real.

O GSM oferecia melhor aproveitamento do espectro, comunicação digital, autenticação do assinante, uso de cartões SIM e capacidade de roaming entre redes compatíveis. Com a evolução das especificações, também permitiria o envio de mensagens SMS e diferentes formas de transmissão de dados.

A Europa, que possuía vários sistemas analógicos incompatíveis, passava a compartilhar uma plataforma. Para uma fabricante como a Nokia, isso representava um mercado muito maior.

O Nokia 1011 e o início do celular digital em massa

Em 10 de novembro de 1992, a Nokia lançou o Nokia 1011. O nome era uma referência à data de lançamento: 10/11 no formato utilizado em boa parte da Europa.

O aparelho é geralmente reconhecido como o primeiro telefone GSM produzido em série. O Science Museum Group registra que o modelo funcionava em 14 países quando chegou ao mercado, algo que demonstrava uma das principais vantagens do novo padrão.

O Nokia 1011 pesava aproximadamente 475 gramas. Era consideravelmente mais leve que o Cityman, mas ainda lembrava um grande bloco preto com antena externa. Sua bateria fornecia cerca de 90 minutos de conversação, dependendo das condições de uso, e a agenda armazenava aproximadamente 99 contatos — algumas fontes arredondam esse número para 90.

Ele não foi o primeiro telefone celular da Nokia nem o primeiro aparelho portátil do mundo. Sua importância estava em ser um telefone GSM fabricado comercialmente em escala, projetado para uma rede digital que poderia atravessar fronteiras.

Naquele mesmo ano, Jorma Ollila assumiu a liderança da Nokia. A empresa estava enfrentando uma crise e ainda carregava negócios muito diferentes. A nova estratégia concentrou recursos em telecomunicações e vendeu várias operações que não faziam parte desse foco.

A Nokia que fabricava papel, botas, cabos, computadores, monitores e televisores começou a desaparecer. Em seu lugar surgiu uma companhia cada vez mais especializada em redes e telefones móveis.

A decisão parecia perigosa. Acabou sendo uma das apostas industriais mais bem-sucedidas da década.

Quando a Nokia passou a caber no bolso

Durante os anos 1990, os telefones deixaram de ser símbolos exclusivos de executivos. Os aparelhos ficaram menores, as redes cresceram e os preços começaram a cair.

A Nokia percebeu cedo que um telefone celular não deveria ser tratado apenas como equipamento de engenharia. Ele também era um objeto pessoal. Precisava ser agradável de segurar, simples de entender e reconhecível.

Os menus eram relativamente diretos. Os aparelhos compartilhavam padrões de interface. As baterias podiam ser trocadas. Capas coloridas permitiam alguma personalização. Toques musicais, jogos e mensagens de texto transformaram o telefone em algo que ia além de fazer ligações.

A empresa também introduziu elementos que se tornariam parte da cultura popular. O toque da Nokia, derivado de um trecho da composição Gran Vals, do músico espanhol Francisco Tárrega, podia ser ouvido em ônibus, escritórios, escolas e ruas de praticamente qualquer país.

O jogo Snake encontrou o ambiente perfeito. Era simples, funcionava em uma tela monocromática e podia ser jogado com poucas teclas. Não precisava de gráficos sofisticados porque o próprio limite técnico fazia parte de seu charme.

Em 1998, a Nokia superou a Motorola e tornou-se a maior fabricante de telefones celulares do mundo. Poucos anos antes, ainda era um conglomerado finlandês tentando decidir quais divisões conseguiria manter.

Nokia 3310: o telefone que virou mito

O Nokia 3310, lançado em 2000, tornou-se o modelo mais associado à fase de ouro da empresa. Ele não foi o celular mais vendido da história, mas provavelmente é o mais lembrado da Nokia.

O aparelho reunia funções que pareciam bastante completas naquele momento: chamadas, mensagens SMS, despertador, calculadora, cronômetro, lembretes e jogos como Snake II, Space Impact, Bantumi e Pairs II.

Sua bateria podia alcançar até cerca de 260 horas em espera, dependendo da versão da bateria e das condições da rede. Esse número não significava 260 horas de uso contínuo. Em conversação, a autonomia era muito menor. Mesmo assim, poder passar vários dias sem procurar um carregador era normal.

O telefone também ganhou fama por sua resistência. Parte dessa reputação veio do corpo compacto, das capas plásticas substituíveis e da ausência de uma grande tela de vidro exposta. Quando o aparelho caía, era comum a tampa e a bateria se soltarem. Bastava montar as peças novamente e ligar.

Com o passar dos anos, essa durabilidade foi transformada em meme. O 3310 passou a ser tratado como um objeto indestrutível, capaz de sobreviver a quedas absurdas ou quebrar o chão antes de sofrer qualquer dano.

A realidade era menos exagerada, claro. Mas a fama não surgiu do nada.

Foram comercializadas aproximadamente 126 milhões de unidades do Nokia 3310. Um número enorme, embora inferior ao de outros aparelhos mais baratos produzidos posteriormente.

O telefone mais vendido não foi o 3310

O líder absoluto de vendas da Nokia foi o Nokia 1100, lançado em 2003 — e não em 2002, como aparece em algumas cronologias.

Ele não impressionava pelas especificações. Tinha tela monocromática, teclado simples, lanterna integrada, bateria removível e recursos básicos de chamadas e mensagens. Era barato, resistente e fácil de usar.

O aparelho foi pensado especialmente para mercados onde eletricidade, assistência técnica e renda disponível podiam ser limitadas. Seu teclado ajudava a evitar a entrada de poeira, a carcaça oferecia boa aderência e a lanterna tinha utilidade real em regiões com fornecimento instável de energia.

A estratégia funcionou. O Nokia 1100 ultrapassou 250 milhões de unidades vendidas, tornando-se não apenas o celular mais vendido, mas um dos produtos eletrônicos de consumo mais vendidos da história.

Existe algo curioso nisso. Enquanto a indústria tecnológica costuma celebrar o aparelho mais avançado, o maior sucesso comercial da Nokia foi um telefone propositalmente básico.

Ele fazia pouco. Fazia esse pouco de forma confiável.

A Nokia dominava o mercado, mas os números precisam ser separados

Em 2007, a Nokia estava no auge. A empresa vendia centenas de milhões de aparelhos por ano e tinha uma estrutura global de fabricação, distribuição e pesquisa.

Algumas narrativas afirmam que sua participação no mercado de celulares era de 51%. Esse percentual se refere melhor ao segmento de smartphones em determinados levantamentos ou períodos, não ao mercado total de telefones.

No terceiro trimestre de 2007, por exemplo, estimativas da Gartner colocavam a Nokia com aproximadamente 38% do mercado mundial de celulares. No mercado de smartphones, sua participação anual ficou próxima de 49%, chegando a cerca de 50,9% no quarto trimestre.

A diferença é importante. Nem todo telefone era um smartphone.

A Nokia já produzia smartphones havia anos, principalmente com o sistema operacional Symbian. A empresa não estava simplesmente presa a telefones básicos com botões enquanto todos os concorrentes criavam aparelhos inteligentes. Modelos das linhas Communicator, Nseries e Eseries ofereciam internet, e-mail, câmeras, aplicativos e recursos de produtividade.

O problema estava mudando de lugar. Já não bastava fabricar um bom aparelho.

O iPhone alterou a definição de smartphone

Quando a Apple apresentou o primeiro iPhone em 2007, não inventou o smartphone, a tela sensível ao toque ou a internet móvel. Esses recursos já existiam.

O que a Apple fez foi reorganizar a experiência.

A tela capacitiva multitoque tornou a interação mais direta. O navegador oferecia uma experiência próxima à de um computador. O sistema, a interface e o hardware eram projetados como partes do mesmo produto. Em 2008, a App Store transformou aplicativos em um mercado centralizado, fácil de acessar e rentável para desenvolvedores.

A Nokia possuía tecnologia, patentes, engenheiros experientes e uma das marcas mais fortes do mundo. Só que sua estrutura de software havia se tornado fragmentada. Diferentes versões do Symbian, interfaces variadas, exigências das operadoras e decisões internas dificultavam a criação de uma experiência consistente.

O Symbian havia sido projetado para uma geração de aparelhos limitada por memória, processamento e bateria. Era eficiente, mas sua arquitetura ficou cada vez mais difícil de adaptar ao mundo das grandes telas sensíveis ao toque e dos aplicativos complexos.

Os engenheiros podiam acrescentar funcionalidades. O problema era transformar tudo em uma plataforma simples para usuários e desenvolvedores.

Android, Symbian e uma transição mal resolvida

Em 2008, o Android chegou comercialmente ao mercado. O sistema do Google oferecia aos fabricantes uma plataforma comum que poderia ser adaptada a aparelhos de diferentes preços.

Samsung, HTC, Motorola, LG e várias empresas chinesas passaram a produzir smartphones Android. O número de modelos cresceu rapidamente. Desenvolvedores podiam criar aplicativos para uma plataforma presente em aparelhos de várias marcas, enquanto o Google oferecia serviços, ferramentas e uma loja centralizada.

A Nokia continuou investindo no Symbian, ao mesmo tempo em que desenvolvia outras iniciativas, como Maemo e MeeGo. O Nokia N900 e, mais tarde, o N9 mostraram que a companhia era capaz de criar sistemas mais modernos. Só que esses projetos não receberam tempo, continuidade ou alinhamento interno suficientes para formar um ecossistema competitivo.

Em fevereiro de 2011, sob a direção de Stephen Elop, a Nokia anunciou uma parceria estratégica com a Microsoft. O Windows Phone passaria a ser sua principal plataforma para smartphones.

A decisão tinha uma lógica. Adotar Android colocaria a Nokia ao lado de dezenas de fabricantes usando o mesmo sistema. O Windows Phone oferecia a possibilidade de formar um terceiro ecossistema, diferente do iPhone e do Android, com apoio financeiro e tecnológico da Microsoft.

Era também uma aposta perigosa em uma plataforma pequena.

Os Lumia chegaram tarde a uma disputa acelerada

Os primeiros resultados da parceria apareceram no final de 2011 com o Nokia Lumia 800 e o Lumia 710.

O Lumia 800 tinha desenho derivado do Nokia N9, corpo em policarbonato e uma interface visual bastante diferente dos concorrentes. O Windows Phone utilizava blocos dinâmicos, os Live Tiles, em vez da grade tradicional de ícones.

Os aparelhos receberam elogios pelo acabamento, pela câmera em modelos posteriores e pela fluidez do sistema. A linha Lumia não foi um fracasso instantâneo sem qualquer venda, como certas versões da história sugerem. Ela construiu uma base de usuários e chegou a obter relevância em alguns países.

Só que nunca alcançou o volume necessário.

O Windows Phone sofria com a falta de aplicativos importantes, atualizações incompatíveis entre gerações e pouca adesão de outros fabricantes. Desenvolvedores priorizavam Android e iOS porque era onde estavam os usuários. Consumidores evitavam o Windows Phone porque faltavam aplicativos. O conhecido ciclo de um ecossistema pequeno.

Enquanto a Nokia realizava essa migração, as vendas dos aparelhos Symbian caíam rapidamente. A linha Lumia não crescia com velocidade suficiente para compensar a perda.

Em 2012, a Samsung ultrapassou a Nokia e assumiu a liderança mundial em telefones celulares. Uma posição que a companhia finlandesa mantivera por cerca de 14 anos desapareceu em pouco tempo.

A Microsoft não comprou a Nokia inteira

Em setembro de 2013, Microsoft e Nokia anunciaram uma transação envolvendo a divisão Devices & Services, responsável pelos telefones celulares. O acordo foi concluído em 25 de abril de 2014.

A Microsoft pagou 3,79 bilhões de euros pelos negócios de dispositivos e serviços e outros 1,65 bilhão de euros pelo licenciamento de patentes. O valor anunciado totalizava 5,44 bilhões de euros, equivalente a pouco mais de 7 bilhões de dólares na cotação daquele período.

Não foi uma compra completa da empresa Nokia. As patentes essenciais também não foram simplesmente vendidas em bloco. Segundo o comunicado oficial da Microsoft, a operação envolvia a aquisição de grande parte da divisão de aparelhos, o licenciamento de patentes e o uso de serviços de mapas.

A Nokia Corporation continuou existindo de forma independente, mantendo negócios de infraestrutura de redes, pesquisa tecnológica, licenciamento e outros ativos. A unidade adquirida passou a operar dentro da Microsoft, com parte da estrutura organizada sob o nome Microsoft Mobile Oy.

Durante algum tempo, a Microsoft continuou usando o nome Nokia em telefones básicos. Nos smartphones, a marca Lumia foi gradualmente modificada para Microsoft Lumia.

A compra não produziu o resultado esperado. Em 2015, a Microsoft registrou uma baixa contábil de aproximadamente 7,6 bilhões de dólares relacionada ao negócio de celulares e anunciou milhares de demissões. Na prática, reconhecia que grande parte do valor da aquisição havia sido perdida.

O retorno da marca por meio da HMD Global

Em 2016, a recém-criada empresa finlandesa HMD Global assinou um acordo de licenciamento com a Nokia Corporation para utilizar a marca Nokia em telefones e tablets.

A operação teve várias partes. A HMD adquiriu da Microsoft determinados direitos relacionados aos telefones básicos e firmou um acordo de uso da marca com a Nokia. A FIH Mobile, subsidiária da Foxconn, adquiriu ativos de fabricação, distribuição e cadeia de suprimentos que pertenciam à operação da Microsoft.

Os novos aparelhos Nokia não eram produzidos pela antiga divisão móvel da Nokia Corporation como antes. Eram desenvolvidos e comercializados pela HMD sob licença de marca, com apoio de parceiros industriais.

A HMD lançou telefones básicos e smartphones Android. Também recuperou nomes históricos, entre eles Nokia 3310 e Nokia 8110, usando a nostalgia como parte da estratégia comercial.

Em 2024, a HMD começou a destacar sua própria marca em smartphones, reduzindo a dependência do nome Nokia em parte do catálogo. Isso gerou a impressão de que a parceria havia acabado completamente. Até 2026, porém, o site da empresa ainda apresenta aparelhos HMD e telefones Nokia e identifica a HMD Global como licenciada da marca Nokia para telefones.

A situação atual é bem diferente daquela vivida no começo dos anos 2000. Nokia Corporation e HMD Global são empresas separadas. Uma é proprietária da marca e de tecnologias licenciadas; a outra desenvolve e comercializa determinados aparelhos usando esse nome.

A Nokia ainda tem relação com telefones, só não os fabrica como antes

Dizer que a Nokia atualmente “não tem nada a ver com telefones celulares” é um exagero.

A Nokia Corporation não opera mais a antiga divisão de celulares de consumo que produziu aparelhos como o 3310, o N95 ou o Lumia 920. Também não concorre diretamente com Apple e Samsung fabricando smartphones sob a mesma estrutura do passado.

A companhia continua profundamente ligada às telecomunicações. Ela desenvolve equipamentos e software para redes móveis, infraestrutura de operadoras, sistemas ópticos, redes IP, soluções para empresas, tecnologias relacionadas ao 5G e pesquisa para futuras gerações de comunicação.

Também administra um portfólio relevante de patentes. Fabricantes de celulares utilizam tecnologias desenvolvidas ou licenciadas pela Nokia, mesmo quando o nome da empresa não aparece no aparelho.

A incorporação da Alcatel-Lucent, concluída em 2016, trouxe para o grupo os Bell Labs, um dos centros de pesquisa mais importantes da história das telecomunicações. O transistor, o Unix, a linguagem C e várias tecnologias de comunicação possuem ligações históricas com esse laboratório.

A Nokia deixou de fabricar o objeto pelo qual ficou conhecida, mas permaneceu na infraestrutura invisível que permite a esses objetos se comunicarem.

Uma empresa que sobreviveu a várias versões de si mesma

A história da Nokia costuma ser contada como uma ascensão seguida por uma queda: uma fábrica de papel se transforma na maior fabricante de celulares do mundo, ignora o iPhone, escolhe o Windows Phone e desaparece.

Essa narrativa é atraente porque é simples. A realidade não é.

A Nokia não ignorou os smartphones. Ela já os fabricava antes da Apple entrar nesse mercado. Também pesquisou telas sensíveis ao toque, tablets, sistemas baseados em Linux, lojas de aplicativos e serviços de internet. O problema foi converter todo esse conhecimento em uma estratégia coerente no momento em que o mercado deixou de ser definido pelo aparelho e passou a ser organizado pelo ecossistema de software.

A empresa sabia fabricar telefones excelentes. Não conseguiu controlar a transição na qual o valor principal migrou para sistemas operacionais, aplicativos, serviços em nuvem e comunidades de desenvolvedores.

Seu tamanho, que havia sido uma vantagem na produção e distribuição global, também dificultou mudanças rápidas. Divisões disputavam recursos. Projetos concorrentes avançavam ao mesmo tempo. Decisões técnicas se misturavam com compromissos assumidos com operadoras e mercados diferentes.

O iPhone não destruiu a Nokia sozinho. O Android também não. Eles expuseram problemas que já existiam e mudaram o mercado numa velocidade que a organização não conseguiu acompanhar.

Mesmo assim, a Nokia não desapareceu.

A empresa que começou processando madeira em 1865, participou da produção de eletricidade, atravessou o setor de borracha e cabos, construiu equipamentos de rádio, liderou a telefonia móvel e perdeu sua divisão de aparelhos ainda existe. Agora trabalha principalmente nos bastidores das redes.

Talvez essa seja a parte mais interessante de sua história. O Nokia 3310 parecia indestrutível, mas a companhia foi ainda mais resistente que o próprio telefone. Não permaneceu igual. Sobreviveu justamente porque, em diferentes momentos, conseguiu deixar para trás aquilo que um dia definiu sua identidade.
Hierarquia de memória: por que o computador precisa de registradores, cache, RAM, SSD e HDD?

Um computador não possui vários tipos de memória apenas porque a indústria criou tecnologias diferentes ao longo do tempo. Essa diversidade existe porque nenhum dispositivo consegue ser, ao mesmo tempo, extremamente rápido, barato, durável, energeticamente eficiente e capaz de armazenar grandes quantidades de dados.

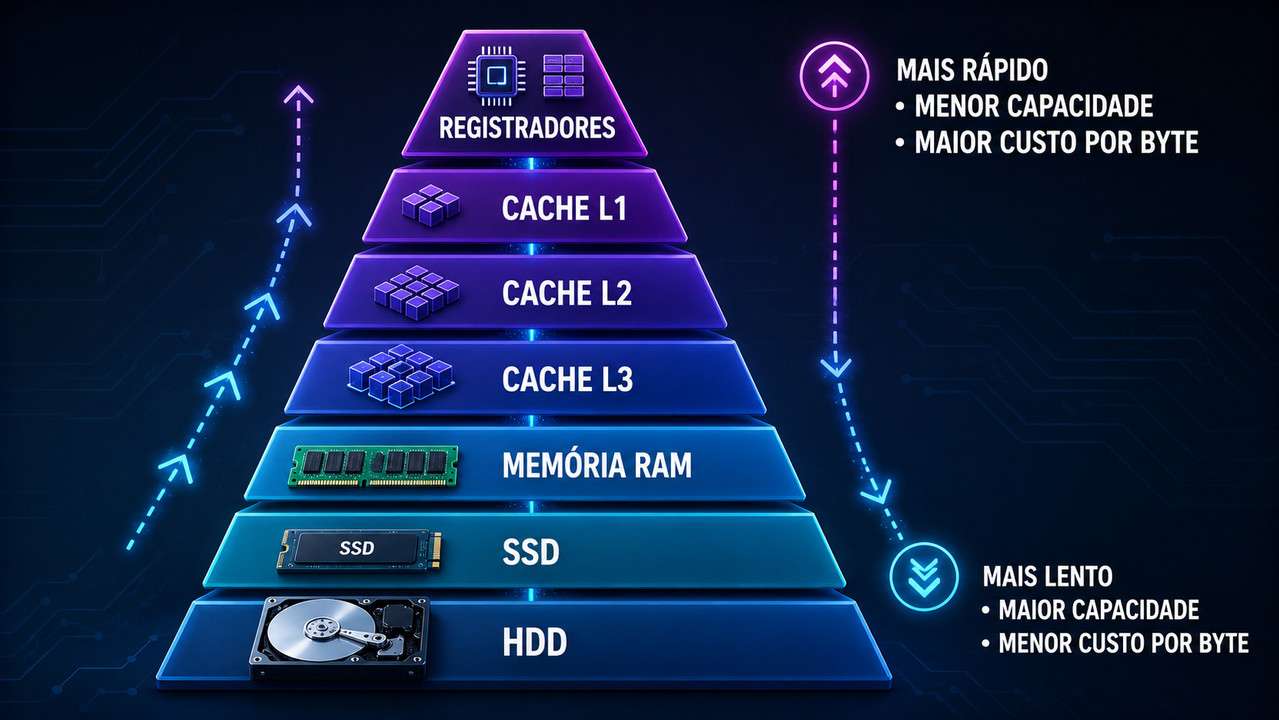
Representação da hierarquia de memória de um computador, dos registradores ao armazenamento em HDD
A hierarquia de memória organiza diferentes tecnologias conforme velocidade, capacidade, custo, consumo de energia e distância física até o processador.

Quanto mais próxima uma memória está das unidades de execução do processador, mais rapidamente seus dados podem ser acessados. Só que essa proximidade tem preço. Registradores e caches ocupam uma área valiosa dentro do chip, consomem energia e são caros por byte. Discos rígidos ficam muito mais distantes do processador e trabalham em outra escala de tempo, mas conseguem guardar terabytes por um custo relativamente baixo.

A hierarquia nasce dessa incompatibilidade.

No topo estão os registradores, pequenos e extremamente rápidos. Logo abaixo aparecem os diferentes níveis de cache. Depois vem a memória principal, normalmente baseada em DRAM. Mais distante encontramos os SSDs, seguidos pelos discos rígidos e por sistemas de armazenamento ainda maiores, como bibliotecas de fitas, armazenamento distribuído e serviços de nuvem.

Não se trata apenas de uma lista organizada do componente mais rápido para o mais lento. Cada nível tenta esconder as limitações do nível seguinte.

Uma biblioteca para entender a hierarquia

Imagine uma pessoa trabalhando em uma grande biblioteca.

Em cima de sua mesa estão algumas folhas com as informações utilizadas naquele exato momento. Elas podem ser alcançadas sem levantar da cadeira. Esse espaço é pequeno, mas o acesso é quase imediato. Na analogia, seriam os registradores do processador.

Ao lado da mesa existe uma estante com os livros consultados com maior frequência. Ainda é um espaço limitado, porém guarda mais informações que a mesa. A pessoa precisa esticar o braço ou levantar rapidamente para alcançar um volume. Essa estante representa a memória cache.

Os demais livros ficam organizados na sala principal da biblioteca. Há milhares deles. Para buscar um título, a pessoa precisa caminhar até a estante correta, localizar a prateleira e retornar. A biblioteca principal corresponde à memória RAM.

Existe também um arquivo no subsolo, onde são guardados documentos que não precisam permanecer disponíveis na sala. O acesso demora mais, mas o arquivo possui espaço muito maior. Podemos associá-lo a um SSD.

Documentos antigos, grandes coleções e materiais raramente consultados talvez fiquem em outro prédio. Um funcionário precisa solicitar o item, esperar sua localização e aguardar o transporte. Esse depósito representa o HDD, os sistemas de fita ou outras camadas de armazenamento de grande capacidade.

Se a pessoa precisasse ir ao outro prédio a cada frase lida, o trabalho seria insuportavelmente lento. Por isso, materiais relevantes são antecipadamente levados para a sala, depois para a estante próxima e finalmente colocados sobre a mesa.

O computador tenta fazer algo semelhante. Dados que provavelmente serão usados em breve são movidos para níveis mais próximos do processador. Quando essa previsão funciona, a CPU continua trabalhando. Quando falha, ela precisa esperar.

E processadores atuais são rápidos demais para esperar sem que isso represente desperdício.

Velocidade não é uma única medida

Quando falamos que uma memória é rápida, podemos estar tratando de duas características diferentes: latência e largura de banda.

Latência é o tempo necessário para iniciar e concluir determinado acesso. É quanto o processador espera até receber a informação solicitada.

Largura de banda representa a quantidade de dados que pode ser transferida durante certo período. Uma memória pode demorar para iniciar uma operação e, depois disso, transferir um grande volume de dados por segundo.

Uma rodovia ajuda a visualizar a diferença. A latência é o tempo que um veículo leva para chegar ao destino. A largura de banda está relacionada ao número de veículos que a estrada consegue transportar simultaneamente.

Discos rígidos ilustram bem essa separação. A leitura aleatória de um pequeno arquivo pode ser lenta porque a cabeça precisa se deslocar e esperar o setor correto passar sob ela. Quando o disco começa a ler um arquivo grande e contínuo, consegue manter uma taxa de transferência razoável.

Em sistemas de inteligência artificial, a largura de banda ganha um peso enorme. Não basta a GPU executar trilhões de operações matemáticas se os dados necessários não chegam às unidades de processamento com velocidade suficiente.

A localidade faz a hierarquia funcionar

A hierarquia depende de um comportamento comum dos programas chamado localidade.

A localidade temporal indica que, se um dado foi usado recentemente, existe uma boa chance de ele ser usado novamente em pouco tempo. Uma variável dentro de um laço, por exemplo, pode ser lida milhões de vezes.

A localidade espacial sugere que, quando um endereço é acessado, os endereços próximos também podem ser necessários. Um programa que percorre um vetor tende a ler seus elementos em sequência.

As caches exploram os dois padrões. Em vez de buscar apenas um byte isolado, o processador normalmente transfere um bloco maior, chamado linha de cache. Se o programa continuar acessando dados próximos, eles já estarão disponíveis.

Isso também explica por que dois programas que realizam a mesma quantidade de operações podem apresentar desempenhos muito diferentes. O primeiro organiza seus dados de maneira previsível e aproveita a cache. O segundo pula entre regiões distantes da memória, provocando falhas de cache e esperas constantes.

O algoritmo continua correto. O processador continua sendo o mesmo. Só mudou a maneira como os dados atravessam a hierarquia.

HDD: bits gravados em uma superfície magnética

O disco rígido é uma mistura impressionante de mecânica de precisão, magnetismo e eletrônica.

Dentro de um HDD existem um ou mais pratos circulares revestidos por material magnético. Esses pratos giram em alta velocidade, normalmente a milhares de rotações por minuto. Pequenas cabeças de leitura e gravação se movem sobre suas superfícies.

A cabeça não encosta normalmente no prato durante a operação. Ela flutua sobre uma camada de ar extremamente fina criada pela própria rotação. Quanto menor a distância segura entre a cabeça e a superfície, maior pode ser a densidade de gravação. A Seagate explica que essas cabeças ficam suspensas sobre essa fina almofada de ar enquanto leem ou alteram regiões magnéticas.

Os dados são representados por propriedades magnéticas de áreas microscópicas do prato. Na escrita, o campo produzido pela cabeça modifica o estado magnético da região. Na leitura, alterações nesse campo são detectadas e convertidas em sinais elétricos.

A mecânica introduz atrasos inevitáveis.

Primeiro, o braço precisa posicionar a cabeça sobre a trilha adequada. Esse movimento produz o tempo de busca. Depois, é necessário esperar que o setor desejado gire até passar sob a cabeça, criando a latência rotacional.

Milissegundos parecem pouco na experiência humana. Para um processador trabalhando em nanossegundos, representam uma eternidade.

O HDD continua relevante porque oferece enorme capacidade por um custo baixo. Data centers, sistemas de backup, servidores de arquivos, vigilância, armazenamento científico e grandes repositórios ainda podem se beneficiar dessa relação entre preço e volume.

Tecnologias como gravação magnética assistida por calor, conhecida como HAMR, permitem aumentar a densidade dos pratos. Nessa técnica, um pequeno laser aquece temporariamente uma área minúscula para facilitar a alteração de sua polaridade magnética, conforme descreve a documentação da Seagate sobre HAMR.

O disco rígido é lento para acessos aleatórios, mas continua difícil de substituir quando a prioridade é guardar muitos terabytes sem transformar cada servidor em um objeto absurdamente caro.

SSD: elétrons presos em células NAND

O SSD elimina pratos, motores e cabeças móveis. Seus dados são armazenados em memória flash NAND, uma tecnologia não volátil capaz de manter informações mesmo sem fornecimento de energia.

Na escala microscópica, a célula NAND utiliza um transistor modificado para reter carga elétrica. Dependendo da arquitetura, essa carga fica armazenada em uma porta flutuante ou em uma estrutura de aprisionamento de carga.

A presença e a quantidade de elétrons modificam a tensão necessária para ativar o transistor. Durante a leitura, o controlador aplica tensões e interpreta em qual faixa o comportamento da célula se encontra.

Uma célula SLC armazena um bit, permitindo dois estados lógicos. MLC, TLC e QLC registram mais bits por célula por meio de vários níveis de tensão. Isso aumenta a capacidade e reduz o custo por gigabyte, mas exige distinguir margens elétricas menores.

Quanto mais estados uma célula precisa representar, mais delicadas ficam a programação, a leitura e a correção de erros. Também tende a existir maior desgaste e menor velocidade de gravação direta quando comparada a células que armazenam menos bits.

Nos SSDs modernos, as células não ficam apenas lado a lado sobre uma superfície plana. A 3D NAND empilha camadas verticalmente, aumentando a densidade sem depender exclusivamente da redução horizontal dos componentes. Existem produtos com centenas de camadas.

A memória NAND trabalha com páginas e blocos. Dados podem ser lidos e programados em páginas, mas o apagamento normalmente acontece em blocos maiores. Isso cria uma complicação: para atualizar determinada informação, o controlador nem sempre pode sobrescrever diretamente a mesma célula.

Ele grava a nova versão em outro local, marca a anterior como inválida e reorganiza blocos posteriormente. Esse processo está ligado à coleta de lixo, ou garbage collection.

O controlador do SSD mantém uma camada de tradução entre os endereços lógicos vistos pelo sistema operacional e as posições físicas da memória. Também executa nivelamento de desgaste, correção de erros, gerenciamento de blocos defeituosos e outras tarefas internas.

Um SSD, então, não é apenas um conjunto de chips NAND. O controlador e seu firmware têm papel decisivo no desempenho e na durabilidade.

Há ainda caches baseadas em DRAM ou em uma região NAND operando temporariamente como SLC. Por isso, certos SSDs gravam rapidamente no início de uma transferência e reduzem a velocidade quando a cache se esgota.

Mesmo com essas limitações, o SSD é muito mais rápido que o HDD em acessos aleatórios porque não precisa movimentar partes mecânicas. Isso muda completamente a inicialização do sistema, a abertura de programas, a instalação de pacotes e a manipulação de milhares de arquivos pequenos.

Armazenamento não é memória principal

SSD e HDD guardam o sistema operacional, os programas e os arquivos quando o computador está desligado. Para executar um programa, seus dados precisam ser carregados para a memória principal.

A diferença não é apenas terminológica.

O armazenamento é persistente e possui grande capacidade, mas sua latência é alta demais para alimentar diretamente o processador em operações comuns. A memória RAM é volátil, mais cara por byte e perde seus dados sem energia, porém oferece acesso muito mais rápido.

Quando abrimos um programa, partes do executável são lidas do SSD e colocadas na RAM. O sistema operacional pode carregar apenas as páginas necessárias, em vez de copiar imediatamente o programa inteiro.

Se a quantidade de memória física se torna insuficiente, o sistema pode mover páginas menos usadas para uma área de troca no armazenamento. No Linux, isso aparece na forma de partição ou arquivo de swap. O mecanismo permite continuar funcionando, mas trocar constantemente páginas entre RAM e SSD causa uma queda perceptível de desempenho.

É outra demonstração da hierarquia. O armazenamento consegue atuar como extensão da memória, só que não adquire a mesma velocidade por receber outro nome.

DRAM: um transistor, um capacitor e uma carga que desaparece

A memória principal de computadores costuma utilizar DRAM, sigla para memória dinâmica de acesso aleatório.

Uma célula DRAM clássica é formada por um transistor e um capacitor. O capacitor guarda uma pequena carga elétrica, enquanto o transistor controla o acesso à célula.

O estado da carga representa a informação. O problema é que capacitores não mantêm essa carga indefinidamente. Pequenas correntes de fuga fazem o valor desaparecer.

Por isso ela é chamada de dinâmica.

O controlador precisa atualizar periodicamente as células, processo conhecido como refresh. Mesmo quando o computador não está alterando determinados dados, a DRAM precisa gastar tempo e energia preservando-os.

A leitura também é delicada. A carga armazenada é minúscula e precisa ser detectada por circuitos chamados amplificadores de sentido. Em muitas implementações, a leitura perturba o estado da célula, exigindo que o valor seja restaurado depois.

Os bits são organizados em matrizes, linhas, colunas, bancos, grupos de bancos, chips, canais e módulos. Antes de acessar uma coluna, o sistema ativa determinada linha e a transfere para os amplificadores de sentido. Se o próximo acesso ocorrer na mesma linha aberta, ele pode ser atendido com menor atraso. Se exigir outra linha, a anterior precisa ser fechada e a nova deve ser ativada.

Essa estrutura ajuda a entender por que a latência da memória não depende apenas da frequência anunciada na embalagem. Temporizações, número de canais, padrão de acesso, controlador, organização dos bancos e concorrência entre núcleos também influenciam o resultado.

DDR significa Double Data Rate. A tecnologia transfere dados em mais de uma transição do sinal de clock, ampliando a taxa efetiva. Gerações como DDR4 e DDR5 aumentaram capacidade, paralelismo e largura de banda, mas a distância de desempenho entre a CPU e a memória principal continua existindo.

A Micron resume a célula DRAM como a combinação de um transistor e um capacitor destinada ao acesso rápido enquanto o sistema está em funcionamento.

Cache: pequena demais para guardar tudo, rápida o suficiente para evitar esperas

Entre a CPU e a DRAM existem as caches.

Elas costumam ser baseadas em SRAM, ou memória estática de acesso aleatório. Diferentemente da DRAM, uma célula SRAM não depende de um capacitor que precisa ser atualizado periodicamente. Uma implementação clássica pode utilizar seis transistores para manter um bit.

Essa estrutura ocupa muito mais área no silício que a célula DRAM de um transistor e um capacitor. Construir gigabytes de SRAM dentro de uma CPU seria caro, grande e energeticamente problemático.

Mas ela é rápida. Então usamos pequenas quantidades.

A cache L1 fica muito próxima das unidades de execução e normalmente é dividida entre instruções e dados. Cada núcleo costuma possuir suas próprias caches L1. Elas têm pouca capacidade, mas oferecem baixa latência e alta largura de banda.

A L2 é maior e um pouco mais lenta. Dependendo da arquitetura, pode ser privada para cada núcleo ou organizada de outra forma.

A L3, também chamada em muitos projetos de cache de último nível, costuma ser compartilhada entre vários núcleos. Possui capacidade maior, mas sua latência é superior à da L1 e da L2.

Os detalhes variam entre processadores. Nem toda arquitetura usa exatamente a mesma organização, e “L3 compartilhada” não significa que todos os núcleos acessem qualquer região com custo idêntico.

Quando a CPU procura um dado, verifica primeiro os níveis mais próximos. Se ele estiver presente, ocorre um cache hit. Se não estiver, temos um cache miss, e a busca continua no próximo nível.

Uma falha em L1 pode ser atendida pela L2. Uma falha em L2 pode encontrar o dado na L3. Se nenhum nível possuir a linha necessária, o controlador precisa buscá-la na DRAM.

A diferença é suficiente para interromper o fluxo eficiente de instruções. Processadores tentam esconder parte desse atraso executando outras operações, prevendo acessos e trazendo dados antecipadamente por meio de mecanismos de prefetch. Nem sempre conseguem.

Sistemas com vários núcleos também precisam manter coerência. Se um núcleo modifica uma informação que outro núcleo possui em sua cache, o hardware precisa impedir que versões incompatíveis sejam usadas como se ambas fossem atuais.

É muita lógica para fazer o acesso à memória parecer simples.

Registradores: onde a operação realmente acontece

No topo estão os registradores.

Eles ficam dentro do núcleo do processador e armazenam operandos, endereços, resultados intermediários, ponteiros e estados usados diretamente pelas instruções.

Quando uma CPU soma dois valores, esses valores normalmente precisam estar em registradores ou ser entregues às unidades de execução por mecanismos internos equivalentes. O resultado também é colocado em um registrador antes de seguir para outro destino.

Registradores são extremamente rápidos, mas existem em quantidade muito limitada. A arquitetura expõe determinados registradores ao conjunto de instruções, enquanto a microarquitetura pode possuir um número físico maior para técnicas como renomeação e execução fora de ordem.

Compiladores trabalham para manter valores importantes nos registradores sempre que possível. Quando faltam registradores, alguns valores precisam ser temporariamente enviados à pilha na memória, operação chamada spill. Isso adiciona acessos e pode reduzir o desempenho.

A Intel descreve a hierarquia começando pelos registradores, passando pela cache L1 e seguindo para níveis progressivamente mais distantes.

Quanto mais perto das unidades de execução, menor a capacidade. Não é coincidência. A área física do chip e o tempo de propagação dos sinais também participam dessa história.

Um dado atravessa várias camadas antes de ser processado

Imagine uma fotografia armazenada em um SSD.

Quando um programa abre o arquivo, o controlador do SSD localiza as páginas NAND correspondentes. Os dados passam pela interface de armazenamento e são colocados em regiões da RAM administradas pelo sistema operacional.

Ao processar a imagem, a CPU solicita blocos dessa memória. Linhas são copiadas para a cache L3, L2 e L1 conforme o padrão de acesso. Valores específicos chegam aos registradores e entram nas unidades vetoriais ou aritméticas.

O resultado segue o caminho inverso. Pode permanecer temporariamente nas caches, voltar à RAM e, quando o programa salva o arquivo, ser enviado ao SSD.

Nem toda etapa acontece de maneira rigidamente sequencial. Existem acesso direto à memória, buffers, filas, caches do sistema operacional, controladores inteligentes e operações assíncronas. O modelo simplificado, porém, revela uma coisa importante: processar dados significa também movimentá-los.

Em muitos programas, a matemática não é a parte mais cara. Levar os operandos até o lugar certo custa tempo e energia.

O problema da “parede da memória”

A capacidade computacional dos processadores cresceu mais rapidamente que a redução da latência da memória principal. Essa diferença é conhecida como memory wall, a parede da memória.

Podemos construir mais unidades de execução, aumentar o paralelismo e realizar mais operações por ciclo. Só que essas unidades precisam receber dados.

Se a memória não fornece informações com largura de banda suficiente, parte do processador fica ociosa. É como construir mais caixas em um supermercado sem ampliar os corredores, o estoque e as esteiras que levam produtos até eles.

Caches maiores ajudam. Prefetch ajuda. Compressão, reorganização de dados, execução fora de ordem e novas interconexões também ajudam.

Nenhuma dessas técnicas elimina o problema. Elas tentam administrá-lo.

A inteligência artificial tornou essa limitação muito mais visível porque modelos atuais trabalham com enormes matrizes de pesos, ativações e estados intermediários. Uma GPU pode possuir uma capacidade matemática extraordinária e continuar limitada pela velocidade com que lê e movimenta esses dados.

Por que a IA precisa de tanta memória?

Um modelo de linguagem contém parâmetros numéricos aprendidos durante o treinamento. Se um modelo possui 70 bilhões de parâmetros e cada parâmetro é armazenado em formato de 16 bits, apenas os pesos ocupam aproximadamente 140 bilhões de bytes, ou cerca de 140 GB na contagem decimal.

Isso é apenas uma aproximação dos pesos.

Durante o treinamento, o sistema também pode precisar guardar gradientes, ativações, estados do otimizador, buffers temporários e cópias dos parâmetros em outras precisões. O consumo total pode ser várias vezes maior que o tamanho bruto do modelo.

Técnicas como paralelismo, checkpointing de ativações, precisão reduzida, particionamento de estados e LoRA tentam reduzir ou distribuir esse custo. O FSDP do PyTorch, por exemplo, divide entre GPUs não apenas parâmetros, mas também gradientes e estados do otimizador, conforme explica a documentação sobre treinamento distribuído.

Na inferência, não precisamos armazenar gradientes de treinamento, mas surge outro consumidor importante: o KV cache.

Transformers produzem chaves e valores usados pelo mecanismo de atenção. Durante a geração, esses resultados são preservados para evitar que todo o contexto anterior seja recalculado a cada novo token.

Quanto maior o contexto, maior tende a ser esse cache. Quanto mais usuários simultâneos e mais sequências em andamento, maior a pressão sobre a memória da GPU.

A documentação da NVIDIA observa que sequências de entrada mais longas aumentam os requisitos de memória da fase de prefill, enquanto saídas longas aumentam os requisitos durante a geração. Em sistemas de larga escala, o KV cache pode ocupar uma parte relevante da memória disponível.

É por isso que aumentar apenas o número de operações por segundo não resolve tudo.

HBM: pilhas de DRAM ao lado do acelerador

GPUs e aceleradores de IA utilizam cada vez mais HBM, sigla para High Bandwidth Memory.

HBM continua sendo DRAM, mas organizada de uma maneira diferente dos módulos DDR instalados em placas-mãe convencionais. Diversos dies de memória são empilhados verticalmente e conectados por vias que atravessam o silício, conhecidas como TSVs.

Essas pilhas são colocadas muito perto do processador, normalmente no mesmo encapsulamento avançado, ligadas por uma interface extremamente larga. Em vez de depender apenas de frequências altíssimas sobre um barramento estreito e relativamente longo, a HBM movimenta muitos bits em paralelo por uma distância curta.

A proximidade e a largura da interface permitem alcançar uma enorme largura de banda. Também ajudam a reduzir a energia consumida por bit transferido quando comparadas a certas abordagens convencionais.

A HBM3e representa uma evolução dessa família. Produtos da geração Hopper e Blackwell utilizaram a tecnologia para ampliar capacidade e vazão de dados.

A NVIDIA informa que a GPU H200 possui 141 GB de HBM3e com largura de banda de até 4,8 TB/s. Em plataformas Blackwell Ultra, determinadas configurações chegam a 288 GB por GPU e até 8 TB/s, segundo as especificações divulgadas pela fabricante.

São números máximos de produtos específicos, não uma característica universal de toda memória HBM3e. O desempenho real de uma aplicação também depende do padrão de acesso, do software, da interconexão, da ocupação do acelerador e de vários outros fatores.

Mesmo assim, a escala é reveladora. Um único acelerador pode movimentar terabytes por segundo porque alimentar suas unidades matemáticas exige uma espécie de sistema circulatório de dados.

A memória de uma GPU ainda pode ser pequena demais

Centenas de gigabytes parecem muito até um modelo grande, seus caches e diversos usuários disputarem o mesmo espaço.

Quando o modelo não cabe em uma GPU, ele pode ser dividido entre várias. Camadas, tensores ou partes dos parâmetros são distribuídos, e os aceleradores precisam trocar resultados durante o processamento.

Agora surge outro nível da hierarquia: a interconexão entre GPUs.

Dentro de um servidor, tecnologias como NVLink oferecem uma comunicação mais rápida que interfaces genéricas. Entre servidores, redes de alta velocidade, como InfiniBand ou Ethernet especializada, transportam dados através do cluster.

A memória deixou de ser apenas aquilo que existe dentro de um chip. Passamos a lidar com uma hierarquia distribuída:

  • registradores e memórias internas das unidades de execução;
  • caches do acelerador;
  • HBM local;
  • memória de outras GPUs;
  • DRAM do host;
  • expansão de memória;
  • SSDs NVMe;
  • armazenamento de rede;
  • grandes repositórios de dados.

Cada salto adiciona latência, consome energia e ocupa a interconexão.

Uma plataforma GB200 NVL72, por exemplo, reúne dezenas de GPUs e oferece vários terabytes de HBM3e, acompanhados por uma malha de comunicação de alta velocidade. Isso não transforma o conjunto em uma única memória perfeita. O software precisa distribuir o modelo e coordenar a movimentação dos dados.

Quanto maior o sistema, mais importante se torna saber onde cada informação está.

O caminho de um modelo de linguagem

Quando um modelo é iniciado, seus pesos podem estar armazenados em SSDs locais ou em um sistema distribuído. Eles precisam ser lidos e carregados para a memória do servidor. Depois, são transferidos para a HBM das GPUs.

Durante a fase de prefill, o prompt do usuário é processado em paralelo para construir as representações internas e o KV cache. Essa etapa costuma utilizar bastante capacidade computacional.

Na geração, o modelo produz tokens progressivamente. Para cada novo token, os pesos precisam participar dos cálculos e o sistema consulta o histórico armazenado no KV cache. Dependendo da configuração, essa fase pode ficar bastante limitada pela largura de banda da memória.

Os dados circulam o tempo inteiro.

Pesos são lidos. Ativações são geradas. Partes do KV cache são consultadas. Resultados atravessam unidades de processamento e, em modelos distribuídos, seguem para outros aceleradores.

Essa movimentação consome energia. Em certas cargas, transportar dados entre memória e processador pode custar mais que a própria operação aritmética.

A discussão sobre eficiência de IA não pode ficar restrita ao número de FLOPS. Também precisamos observar bytes movimentados, largura de banda utilizada, capacidade ocupada, padrões de acesso e energia por transferência.

Uma multiplicação executada rapidamente não ajuda se os operandos chegam atrasados.

O armazenamento continua abaixo da inteligência artificial

HBM recebe atenção porque está diretamente associada aos aceleradores, mas a cadeia não começa nela.

Modelos precisam ser treinados com grandes conjuntos de dados. Esses conjuntos vivem em repositórios compostos por SSDs, HDDs, armazenamento de objetos e sistemas distribuídos. Checkpoints de treinamento também precisam ser gravados periodicamente.

Se milhares de GPUs esperarem os dados de treinamento chegarem, equipamentos caríssimos ficam ociosos.

Data centers utilizam caches em SSD, pré-carregamento, formatos otimizados, particionamento e pipelines paralelos para manter os aceleradores ocupados. Dados podem passar do armazenamento distribuído para SSDs locais, depois para a DRAM do servidor e finalmente para a HBM.

Durante a gravação de checkpoints, o caminho se inverte. O sistema precisa retirar grandes volumes de dados dos aceleradores sem interromper o treinamento por tempo demais.

O HDD continua presente em camadas de grande capacidade. SSDs aparecem onde latência e taxa de acesso importam mais. DRAM funciona como área de trabalho. HBM alimenta diretamente o acelerador.

A antiga pirâmide de memória não desapareceu na era da inteligência artificial. Ela ficou maior.

Não existe memória perfeita, apenas escolhas menos ruins

Poderíamos perguntar por que não fabricar um computador usando apenas a tecnologia mais rápida disponível.

Porque a máquina ficaria cara, quente e pequena em capacidade.

Também poderíamos usar apenas a memória mais barata. Nesse caso, o processador passaria a maior parte do tempo esperando.

A engenharia procura um equilíbrio. Pequenas quantidades de memória muito rápida ficam perto do processamento. Grandes quantidades de armazenamento mais lento ocupam os níveis inferiores. Hardware, sistema operacional, compiladores e aplicações trabalham juntos para manter os dados certos no lugar certo.

Essa organização funciona tão bem que normalmente não percebemos sua existência. Abrimos um programa e vemos uma janela. Carregamos um jogo e observamos uma tela. Enviamos um prompt e recebemos uma resposta.

Por trás desse gesto simples, bytes podem ter saído de um SSD, atravessado a RAM, entrado em diferentes níveis de cache, chegado aos registradores e retornado. Em um data center de IA, talvez tenham circulado entre dezenas de aceleradores antes de produzir uma única palavra.

A computação moderna não depende apenas de realizar cálculos. Depende de alimentar esses cálculos sem deixar a máquina esperando.

O processador pode ser o componente que executa as instruções, mas a hierarquia de memória decide com que frequência ele realmente terá algo para fazer.

Data center e problemas hídricos

Data Center

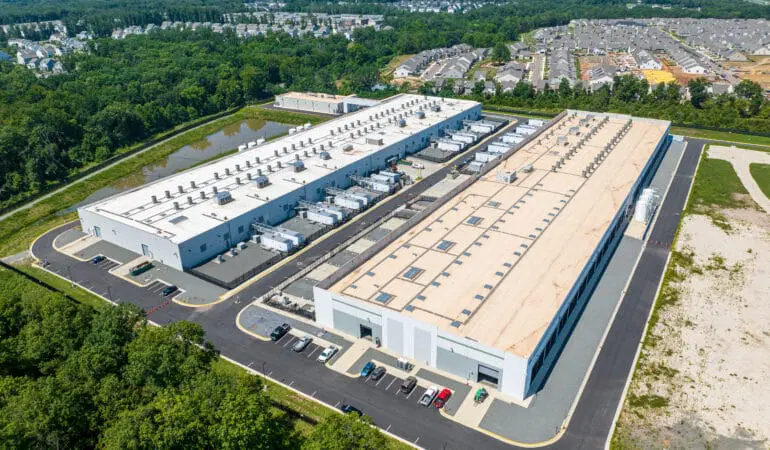
Hoje em dia os data center demanda muita energia, o que está dando um problema grave hídrico. A maioria dos data center de treinamento de Inteligência Artificial funciona assim: você junta milhares de servidores, cada um lotado de GPUs, liga tudo com uma rede absurdamente rápida, alimenta o conjunto com dados em velocidade industrial, e transforma eletricidade em cálculos, cálculos em calor, calor em água evaporada ou em sistemas de refrigeração cada vez mais complexos.

Parece simples na frase, só que por dentro é uma fábrica de termodinâmica. O treinamento de modelos grandes é um processo distribuído, o modelo “mora” em pedaços espalhados por centenas ou milhares de GPUs, cada pedaço calculando gradientes e sincronizando resultados o tempo todo. Isso exige não só GPU, exige memória, armazenamento, rede, orquestração, redundância, e um prédio inteiro feito para não derreter.

O data center de IA por dentro, o caminho da energia até virar resposta

A primeira é a camada de computação, onde ficam as GPUs e CPUs. Em IA moderna, as GPUs viraram o motor principal porque conseguem fazer muitas multiplicações e somas em paralelo, que é justamente a moeda do treinamento. A densidade de potência por rack disparou, um rack que antes era “pesado” com alguns quilowatts hoje pode virar dezenas de quilowatts, e em projetos de IA isso sobe ainda mais. Isso muda tudo, muda a forma de distribuir energia no piso, muda o tipo de cabo, muda a arquitetura de refrigeração, muda até o quanto um prédio aguenta sem virar um forno.

A segunda camada é a rede. Treinar um modelo grande não é um monte de computadores independentes, é um “cérebro coletivo” que precisa conversar o tempo inteiro. A rede vira parte do computador. Por isso entram tecnologias de interconexão de altíssima banda e baixa latência, e por isso, quando alguém fala que “é só comprar mais GPU”, está ignorando que sem rede decente você compra gargalos caros.

A terceira camada é armazenamento e dados. O treinamento é uma esteira, dados chegam, são pré-processados, entram em lotes, geram atualizações. Só que dados grandes não são arquivos bonitinhos, são petabytes, e petabyte não gosta de improviso. Quando o armazenamento engasga, as GPUs ficam ociosas, e GPU ociosa é dinheiro queimando e energia desperdiçada.

A quarta camada é a infraestrutura predial, energia e refrigeração. E aqui aparece o truque que pouca gente vê: muitas vezes a “TI” é a menor parte do problema físico. O resto é entregar energia com estabilidade e tirar calor sem depender de milagres.

É por isso que existem métricas como PUE, Power Usage Effectiveness, que mede a razão entre a energia total do data center e a energia que chega de fato nos equipamentos de TI, quanto mais perto de 1, melhor. PUE virou padrão internacional formalizado em norma ISO.

Só que, quando a conversa é IA, entra um segundo fantasma, a água. Aí aparece outra métrica, WUE, Water Usage Effectiveness, litros de água por kWh gasto pela TI. Essa conta expõe um detalhe desconfortável: dá para ser “eficiente em energia” e ainda assim ser um monstro hídrico, depende do tipo de resfriamento e do clima.

Por que IA puxa a tomada com tanta força

Data center sempre gastou energia, a nuvem já era uma indústria gigantesca. O salto recente tem uma assinatura clara, a aceleração por IA. A Agência Internacional de Energia projeta que o consumo elétrico global de data centers pode mais que dobrar e chegar perto de 945 TWh em 2030, com crescimento anual na casa de ~15% no período 2024–2030, e a própria IEA coloca IA como o principal motor dessa alta, com demanda de data centers otimizados para IA crescendo várias vezes até 2030.

Isso não é só “mais servidores”. IA empurra o limite físico do rack, e quando a densidade sobe, o que antes era “ar condicionado de sala grande” vira um projeto térmico quase de indústria pesada.

A consequência direta é que energia deixa de ser um item de custo e vira gargalo estratégico. Não basta ter dinheiro, tem que ter conexão com a rede elétrica, tem que ter subestação, tem que ter transformador, tem que ter licença, tem que ter contrato, tem que ter previsibilidade. Em muitos lugares, o tempo para conseguir a interligação com a rede vira o cronograma real do projeto, não a obra do prédio.

E existe um efeito colateral bem humano nisso: quando um data center entra numa região, ele compete com todo mundo por infraestrutura. A conversa vira política local. Quem recebe a energia? Quem paga pela expansão da rede? Quem absorve o risco quando dá pico? Quem segura a bronca quando falta água?

A água, o recurso que some “sem barulho”

O problema hídrico não é um acidente, ele é uma escolha técnica que, durante décadas, foi razoável. Muitos data centers usam resfriamento evaporativo ou torres de resfriamento porque água evaporando é um jeito eficiente de remover calor. Funciona muito bem, especialmente em climas secos. Só que eficiência física não é sinônimo de sustentabilidade social.

Para dar escala mental, relatórios e levantamentos recentes usam números que assustam quando saem do abstrato. Um relatório do governo do Reino Unido sobre uso de água em data centers e IA cita que um data center de 100 MW pode consumir em torno de 2,5 bilhões de litros por ano, algo comparável às necessidades de dezenas de milhares de pessoas, e traz a ideia de competição direta com água potável em períodos de seca, com risco de conflito social em áreas de estresse hídrico.

Esse mesmo relatório cita estimativas globais em que o setor de data centers consome centenas de bilhões de litros de água por ano, com projeções que podem subir de forma relevante até 2030.

A parte mais irritante é que, em muitos casos, o cidadão não “vê” essa água indo embora. Não é uma indústria com chaminé óbvia. É um galpão limpinho, com cerca, com logo moderno, e o consumo aparece na conta municipal como uma curva subindo.

WUE ajuda a tirar o véu. Há fontes que colocam médias de WUE por volta de ~1,8 a 1,9 L/kWh em data centers, com variação grande por clima e tecnologia, e com metas de projetos bons tentando ficar bem abaixo disso.

Só que WUE também tem pegadinha: ele costuma medir a água “no site” e relacionar com a energia de TI. A água escondida na geração de energia pode ser enorme. Dependendo de como a eletricidade é produzida, existe água usada na cadeia inteira, resfriamento de termelétricas, perdas, reservatórios, mineração, e isso vira uma espécie de “água virtual” do modelo. O relatório do Reino Unido bate nessa tecla, falando do elo água-energia e do quanto o impacto vai além do perímetro do data center.

Tem mais um capítulo que quase ninguém lembra, fabricação de chips. Os aceleradores de IA são semicondutores avançados, fabricados com processos que usam água ultra pura em volumes grandes para limpeza e enxágue de wafers. Mesmo que o operador do data center não controle isso diretamente, faz parte da pegada hídrica total.

Por que a crise hídrica aparece agora, a mistura de densidade e geografia

Se você coloca uma fazenda de GPUs num lugar frio, com água abundante e energia limpa, a história fica menos dramática. Só que o mundo real adora ironia: muita capacidade de data center cresce perto de grandes centros econômicos, onde a terra é cara, a água é disputada, e a energia já vive no limite. Em regiões quentes, o resfriamento exige mais trabalho, e em regiões secas, evaporar água parece uma tentação técnica, só que é justamente onde a água já é um tema delicado.

Reportagens recentes vêm explorando exatamente esse choque, data centers crescendo em regiões com estresse hídrico, com iniciativas tentando reduzir consumo de água e, ao mesmo tempo, esbarrando no trade-off clássico, reduzir água costuma aumentar energia, porque sistemas “waterless” frequentemente precisam de mais ventilação, mais compressão, mais refrigeração mecânica.

Esse trade-off é a essência do problema. A física não dá desconto. Você tira calor do chip e joga em algum lugar, ar, água, líquido dielétrico, circuito fechado, e cada escolha cobra um preço diferente.

As soluções técnicas mais citadas, e por que nenhuma é mágica

1) Resfriamento líquido direto no chip (direct-to-chip).
Em vez de soprar ar gelado e esperar que o calor saia do dissipador, você coloca líquido circulando em placas frias próximas ao chip. Isso permite densidades maiores com menos consumo de água no site, dependendo do sistema. É um caminho natural quando racks viram “mini-usinas”.

2) Imersão (immersion cooling).
Os servidores ficam mergulhados em um fluido especial, que remove calor de forma eficiente. Pode reduzir espaço e facilitar densidade, só que muda manutenção, muda fornecedores, muda tudo, e ainda precisa rejeitar calor para o ambiente em algum ponto.

3) Sistemas de circuito fechado e reaproveitamento.
Em vez de usar água potável e evaporar, dá para recircular e usar trocadores de calor mais inteligentes. Só que a conta de energia pode subir, e a complexidade operacional aumenta.

4) Migração geográfica e design orientado a clima.
Construir onde o clima ajuda é uma solução elegante no papel. Na prática, esbarra em latência, em disponibilidade de rede, em regulação, em impostos, em mão de obra, em incentivos locais.

5) Reuso de calor.
O calor de data center pode aquecer prédios, água de distrito, processos industriais. Em alguns países isso faz sentido econômico. Em muitos lugares, falta infraestrutura para capturar e distribuir esse calor, e o calor vira desperdício.

O ponto importante é que eficiência não é uma chavinha, é um ecossistema de decisões. PUE é útil, WUE é útil, só que a métrica sozinha vira maquiagem se você otimiza um lado e explode o outro.

Os potenciais, o lado em que isso pode valer a pena como sociedade

Até aqui parece que data center é um vilão de ficção científica que bebe rios. Só que o lado útil é real, e dá para falar dele sem romantizar.

A capacidade de computação concentrada permite avanços em áreas onde simulação e modelagem são vitais, descoberta de fármacos, previsão meteorológica, otimização de redes elétricas, engenharia de materiais, tradução e acessibilidade, automação de tarefas repetitivas em saúde e serviços, educação personalizada quando feita com responsabilidade. A própria IEA discute o potencial de IA para transformar como o setor de energia opera, com ganhos de eficiência, previsão e integração de renováveis, desde que seja aplicada com objetivo e governança.

Existe um uso interessante e meio subestimado: IA para operar o próprio data center. Prever carga, deslocar workloads, ajustar resfriamento em tempo real, reduzir desperdício, detectar falhas antes de virar pane. É a versão moderna de “o monstro ajuda a domar o monstro”.

E tem um argumento econômico que, goste ou não, pesa. Data centers são infraestrutura estratégica. Eles atraem investimento, empregos indiretos, arrecadação, e funcionam como base para empresas locais consumirem computação sem depender de continentes de distância. Países e estados tratam isso como corrida industrial.

Os problemas, onde a conta chega sem pedir licença

1) Emissões e o risco de empurrar a rede para fontes fósseis.
Quando a demanda cresce mais rápido que a capacidade limpa, a energia marginal pode vir de térmicas, e isso piora emissões. Matérias recentes chamam atenção para o crescimento acelerado e para casos em que expansão de capacidade e uso de combustíveis fósseis entram na mesma frase, justamente porque a velocidade do “boom de IA” pressiona sistemas elétricos que já estão no limite.

2) Falta de transparência.
Sem dados claros, a sociedade fica discutindo no escuro. Há pressão para exigir divulgação de consumo de energia, água e emissões, porque hoje muita informação é voluntária e fragmentada, e isso impede planejamento público e fiscalização séria.

3) Competição por água potável em períodos críticos.
O relatório do Reino Unido explicita esse ponto, a dependência de água potável para resfriamento pode competir com abastecimento humano, e em secas pode gerar restrições e conflitos.

4) Concentração do impacto.
Uma cidade pode sentir muito mais que a média global. Estudos e revisões citam exemplos em que instalações representam fatia relevante do consumo municipal, como o caso citado para The Dalles, nos EUA, em que o consumo de um data center aparece como parcela grande do uso da cidade em certos anos.

5) Pegada material e cadeia de suprimentos.
A conversa não termina na conta de luz e água. GPU e infraestrutura têm carbono incorporado, mineração, refino, fabricação, transporte, descarte. A cada ciclo de upgrade, uma montanha de hardware muda de lugar. Esse lado é menos visível, e por isso é fácil ignorar.

6) O risco do “rebound effect”, eficiência que vira expansão.
Você melhora eficiência do modelo, reduz custo por inferência, e de repente surgem dez novos produtos, todos rodando IA o dia inteiro. O consumo total sobe mesmo com eficiência melhorando. Esse efeito aparece em várias áreas da economia, IA não é exceção.

Onde dá para atacar o problema de forma prática, sem virar teatro

Tem um caminho que envolve engenharia e governança ao mesmo tempo.

Na engenharia, a redução de desperdício computacional é ouro. Técnicas como quantização, distilação, sparsity, treinamento mais inteligente, fine-tuning em vez de treinar do zero, tudo isso reduz energia por resultado útil. Existe uma diferença brutal entre “treinar porque dá” e “treinar porque precisa”.

Na operação, dá para deslocar carga. Treinamentos longos podem ser agendados para horários de maior oferta renovável, ou para regiões com melhor perfil energético, desde que a arquitetura do sistema permita. Não resolve tudo, só que é melhor do que ignorar o relógio e a rede.

Na infraestrutura, a escolha do resfriamento deve considerar bacia hidrográfica, não só custo. WUE deveria entrar em licenciamento e contratos de forma explícita, com metas e auditoria. Se o data center promete “water positive”, a pergunta adulta é “em qual bacia, com qual metodologia, com que verificação”.

Na política pública, transparência é o primeiro passo que não depende de tecnologia futurista. Medir e reportar consumo de energia, água e emissões, com metodologia padronizada, cria base para planejamento. Relatórios como o do Reino Unido defendem exatamente a necessidade de dados confiáveis para governança, e apontam que esforços voluntários podem ser insuficientes quando a curva de crescimento é agressiva.

E existe uma conversa que pouca gente quer ter, priorização. Nem todo uso de IA é igualmente valioso. Treinar modelos gigantes para ganhar décimos de ponto em benchmark pode ser ciência, pode ser marketing, pode ser as duas coisas. Quando água e energia viram recursos em disputa, a pergunta “isso vale o custo social” para de ser filosofia e vira administração pública.

O século passado tratou eletricidade como base invisível da economia. Este século está tratando computação como base invisível da economia. A diferença é que agora a base invisível esquenta, evapora água, pressiona rede e entra na política local como um novo tipo de indústria, limpa por fora, intensa por dentro. A boa notícia é que o problema é material e mensurável, dá para modelar, dá para regular, dá para projetar melhor. A má notícia é que a curva de crescimento é rápida, e curvas rápidas punem sociedades que gostam de decidir devagar.


Referências

Information technology — Data centres — Key performance indicators https://www.iso.org/standard/63451.html

Data Centers and Water Consumption https://www.eesi.org/articles/view/data-centers-and-water-consumption

Energy demand from AI https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai

Desert storm: Can data centres slake their insatiable thirst for water? https://www.reuters.com/sustainability/climate-energy/desert-storm-can-data-centres-slake-their-insatiable-thirst-water--ecmii-2025-12-17/

AI is set to drive surging electricity demand from data centres while offering the potential to transform how the energy sector works https://www.iea.org/news/ai-is-set-to-drive-surging-electricity-demand-from-data-centres-while-offering-the-potential-to-transform-how-the-energy-sector-works

‘Just an unbelievable amount of pollution’: how big a threat is AI to the climate? https://www.theguardian.com/technology/2026/jan/03/just-an-unbelievable-amount-of-pollution-how-big-a-threat-is-ai-to-the-climate

Call to make tech firms report data centre energy use as AI booms https://www.theguardian.com/technology/2025/feb/07/call-to-make-tech-firms-report-data-centre-energy-use-as-ai-booms

The water use of data center workloads: A review and assessment of key determinants https://escholarship.org/uc/item/1vx545q7

Meta e Google desafiando o ecossistema da Nvidia

Nvidia

A Nvidia não ficou gigante só porque fez uma GPU rápida e mandou uma nota fiscal junto. Ela ficou gigante porque transformou um detalhe técnico em hábito cultural: a ideia de que “fazer IA de verdade” é, por definição, fazer IA em CUDA.

Isso é mais poderoso do que um chip. Um chip você troca quando aparece outro melhor. Um hábito você troca quando a dor de mudar fica menor do que a dor de continuar do mesmo jeito.

Durante anos, o mercado contou uma história confortável para explicar o domínio da Nvidia: “as GPUs são as mais avançadas”. Essa frase tem um pedaço de verdade, só que ela serve melhor como marketing do que como explicação. Se desempenho bruto fosse o único juiz, a coroa teria mudado de cabeça várias vezes. Houve gerações em que concorrentes ficaram perto, houve soluções mais baratas, houve momentos em que o custo por desempenho parecia tentador. Mesmo assim, quase ninguém fez a troca em massa.

Porque o trono da Nvidia não fica só no silício. O trono fica na camada onde as equipes gastam anos da vida: ferramentas, bibliotecas, kernels, rotinas de treino distribuído, perfiladores, receitas de otimização, tutoriais, exemplos, bugs conhecidos, jeitos de debugar, jeitos de contratar. Um ecossistema que vira padrão não precisa obrigar ninguém. Ele só precisa fazer o resto parecer trabalhoso.

E aí entra o que mudou, com o peso de um “clique” que desencaixa um império: Google e Meta estão mirando exatamente a peça que sustenta esse aprisionamento invisível, o software. Em dezembro de 2025, a Reuters noticiou que o Google está trabalhando num projeto interno chamado TorchTPU, com o objetivo de tornar as TPUs mais naturais para quem desenvolve em PyTorch, com colaboração próxima da Meta, grande apoiadora do PyTorch, e com possibilidade de abrir partes do software para acelerar adoção.

A ambição é simples de dizer e brutal de executar: permitir que empresas mudem de Nvidia para TPU sem precisar reescrever as partes críticas do código, sem desmontar o stack inteiro, sem abandonar PyTorch. Se essa fricção cair, a conversa deixa de ser “Nvidia ou caos” e vira “Nvidia ou concorrência”. A Nvidia pode continuar excelente e ainda assim perder a coisa que mais importa em mercados maduros: poder de barganha.

O lock-in que ninguém assina, mas todo mundo sente

Quando se fala em lock-in, muitos imaginam contrato, cláusula, exclusividade. No caso da Nvidia, a amarra é mais elegante, e por isso mais perigosa: ela se esconde no custo prático da mudança.

Uma equipe que diz “nosso modelo roda em PyTorch” geralmente quer dizer algo mais específico, mesmo que não verbalize: “nosso modelo foi escrito, treinado, ajustado, validado e colocado em produção num mundo em que CUDA era o chão”.

CUDA, na prática, virou o sistema nervoso periférico do stack de IA. Não é só “um jeito de rodar na GPU”. É um conjunto de escolhas acumuladas:

  • bibliotecas de alto desempenho para operações essenciais,
  • caminhos de precisão mista e quantização que foram refinados por anos,
  • comunicação entre GPUs e entre nós de cluster, com soluções já testadas no inferno do tráfego real,
  • profilers, ferramentas de debug, mecanismos de compilação, kernels otimizados e, talvez o mais importante, a “memória muscular” dos times.

Mudar isso não é trocar uma peça. É mexer na base do prédio enquanto tem gente morando dentro.

Por isso o lock-in da Nvidia sempre foi mais psicológico e operacional do que técnico. Em empresas, risco é uma moeda cruel. Risco de regressão, risco de instabilidade, risco de atraso, risco de gastar meses para descobrir que um detalhe do pipeline não tem equivalente. A conclusão prática era automática: ficar na Nvidia parecia racional, mesmo quando era caro.

E aqui tem um ponto curioso, quase irônico: a Nvidia nunca controlou o PyTorch. O PyTorch nasceu dentro da Meta e cresceu como projeto aberto, virando o framework dominante por mérito próprio, do laboratório à produção. O que a Nvidia fez, com genialidade de quem entende o jogo, foi se integrar tão bem que parecia dona.

Integração não é posse. Se o PyTorch ganhar um caminho “sem drama” para rodar bem fora de CUDA, a maior barreira de saída começa a virar poeira.

Por que “existem alternativas” nunca foi suficiente

“Mas já existem alternativas”, alguém sempre diz, e tecnicamente isso é verdade. AMD tem ROCm, Intel tem seus esforços, há aceleradores específicos, há chips especializados em inferência. Só que o mercado de IA em escala não premia apenas a existência de uma alternativa, ele premia uma alternativa que tenha três coisas ao mesmo tempo:

  1. performance competitiva em cargas relevantes,
  2. maturidade operacional, aquela sensação de “isso não vai me trair em produção”,
  3. compatibilidade com o jeito que o mundo já trabalha.

A maioria falha na terceira. Algumas falham na segunda. Várias falham nas duas.

A Nvidia virou o “default” porque fez o caminho parecer inevitável. Não por decreto, por conforto. Quando tudo funciona, quando os tutoriais batem com a realidade, quando a equipe encontra respostas, quando dá para contratar gente que já sabe o stack, a escolha vira hábito. E hábito é um tipo de monopólio emocional.

É por isso que a movimentação do Google assusta: ela não tenta vencer a Nvidia “na pancada” só com hardware. Ela tenta vencer no ponto onde o hábito se forma, a experiência do desenvolvedor.

TPUs: o problema nunca foi músculo, foi idioma

As TPUs do Google sempre carregaram um ar de “poder oculto”, aquele tipo de hardware que a gente ouve falar como se fosse uma arma interna, restrita, feita para as necessidades do próprio Google. A leitura confortável para a Nvidia era: “isso não importa para o mercado, porque ninguém fora do Google usa”.

Só que essa leitura era superficial. O próprio Google Cloud descreve TPUs como aceleradores desenhados para treinamento e inferência de modelos de IA, e elas já sustentam cargas gigantes dentro do ecossistema do Google. O que travava a adoção ampla não era falta de desempenho. Era o idioma de software.

Por muito tempo, o Google apostou com força em JAX e no universo de compilação ligado ao XLA. De novo, tecnicamente faz sentido. Só que o mercado não funciona como seminário de compiladores. Enquanto o Google empurrava um caminho mais “puro”, o resto do planeta consolidava outro caminho: PyTorch.

Para a maioria das empresas, adotar TPU significava adotar um jeito diferente de pensar, adaptar pipelines, revalidar tudo, treinar equipe, e no final ainda ficar com a sensação de estar fora do fluxo principal da indústria. Empresas não migram frameworks por hobby. Elas migram quando são empurradas por dor extrema ou quando a migração é suave.

O que o TorchTPU tenta fazer é inverter a lógica: em vez de pedir que o desenvolvedor se adapte ao hardware, o hardware passa a “se adaptar” ao desenvolvedor.

“Mas já existe PyTorch em TPU”, então qual é o drama?

Aqui entra uma camada importante, que separa “dá para rodar” de “dá para viver”.

O mundo já tem, faz tempo, o PyTorch/XLA, que conecta PyTorch a dispositivos XLA como TPUs. Isso está documentado oficialmente e existe como projeto público. E até em notas antigas do próprio Google Cloud aparece a ideia de suporte via integração PyTorch/XLA.

Então por que ainda existe espaço para um TorchTPU “novo”?

Porque “rodar” não significa “rodar do jeito que o desenvolvedor espera”. Na prática, muitas integrações desse tipo carregam pequenas fricções que, somadas, viram um pedágio enorme: diferenças de cobertura de operadores, comportamentos inesperados, caminhos mais frágeis para debug, diferenças no desempenho por tipo de modelo, desafios de distribuição, tooling menos maduro, e um detalhe que virou central no PyTorch moderno: a experiência eager, aquela sensação de que você escreve o código e ele responde na hora, com o mesmo modelo mental em todo lugar.

Em outubro de 2025, surgiu no próprio repositório do PyTorch/XLA uma proposta explícita para evoluir a experiência e chegar mais perto de algo “nativo”, com a ambição de fazer tensor.to('tpu') parecer tão natural quanto tensor.to('cuda'). Esse é o tipo de frase que parece pequena, até você perceber o que ela realmente significa: transformar TPU de “backend especial” em “cidadão de primeira classe” dentro do PyTorch.

E isso muda o jogo porque reduz a parte mais cara da migração, a parte humana: reaprender o mundo.

O que o TorchTPU realmente ameaça na Nvidia

O mercado gosta de imaginar batalhas de hardware como corrida de cavalos: quem tem mais FLOPS, quem tem mais memória, quem tem mais largura de banda. Só que a Nvidia construiu uma fortaleza onde o hardware é apenas a muralha visível. O fosso está no software, e o fosso é feito de custo de troca.

O TorchTPU, pelo que foi reportado, mira exatamente isso: tornar TPUs amigáveis para o maior framework do planeta, sem exigir que times mudem seu código nem abandonem PyTorch, com colaboração da Meta, e com possibilidade de abrir partes do stack para ganhar tração mais rápido. Essa ameaça não é “as GPUs vão morrer”. Essa ameaça é “as GPUs deixam de ser a única resposta sensata”.

Em mercados de infraestrutura, “única resposta sensata” é como se fabrica margem alta. Quando o cliente não tem alternativa viável, ele aceita preço, prazo, pacote completo, aceitação resignada. Quando aparece uma alternativa boa o suficiente, o cliente não precisa nem migrar para já mudar a conversa. Ele só precisa conseguir dizer, com credibilidade: “eu posso ir embora”.

A Nvidia, por anos, vendeu previsibilidade. “Seu código roda aqui, seu time sabe mexer aqui, seu risco é menor aqui.” Isso sustenta múltiplos altos porque vira uma espécie de seguro embutido. Só que seguro perde valor quando a apólice concorrente fica boa.

Por que a Meta muda o peso específico dessa história

Se esse movimento viesse só do Google, parte do mercado trataria como mais um capítulo do “Google tentando competir com Nvidia”. O Google tem histórico de projetos tecnicamente brilhantes que demoram a virar hábito fora da própria casa.

A Meta muda isso por três motivos. Primeiro, porque a Meta tem interesse econômico brutal em diversificar. O custo de treinamento e inferência em escala de rede social global é um monstro que nunca dorme. Depender de um único fornecedor, num mercado com filas, prazos e preços agressivos, é aceitar fragilidade estratégica. Segundo, porque a Meta é o berço do PyTorch e continua sendo uma força determinante na sua evolução. Quando a empresa que ajudou a criar o framework participa da portabilidade de forma ativa, a chance de isso virar padrão aumenta, porque não é um “plugin lateral”, é o coração do ecossistema se mexendo. Terceiro, porque isso cria efeito cascata. Quando o criador do framework dá sinais de que múltiplos backends importam, ferramentas ao redor se adaptam, bibliotecas seguem, integradores entram, provedores oferecem suporte, e a profecia começa a se autorrealizar.

Esse ponto conversa com outra peça do tabuleiro: não é só software. O Google também tem buscado expandir o negócio de TPUs para fora do seu “jardim murado”, com reportagens indicando oferta de TPUs para uso em data centers de clientes e interesse de grandes compradores. Quando você junta “hardware disponível” com “experiência de PyTorch mais nativa”, o obstáculo deixa de ser filosófico e vira operacional, e isso é o tipo de coisa que compras e infraestrutura entendem muito bem.

O que muda quando “sair” deixa de ser impensável

Aqui é onde o mercado às vezes erra o foco. O preço da ação pode reagir pouco no começo porque o mundo ama narrativas simples, e a narrativa simples é: “Nvidia continua líder, ponto”. Só que a ameaça verdadeira costuma ser lenta, silenciosa e burocrática. Ela nasce em comitê de arquitetura, em prova de conceito, em planilha de custo por inferência.

Quando existe alternativa real, acontecem mudanças bem específicas:

  • Negociação: o cliente passa a negociar preço e condições com mais força, mesmo sem trocar nada no curto prazo.
  • Planejamento: times começam a desenhar pipelines com portabilidade em mente, para não serem reféns.
  • Padronização: ferramentas passam a assumir múltiplos backends como normal, e isso reduz a vantagem do “default histórico”.
  • Margem: margens caem antes da participação de mercado cair, porque o poder de precificação é o primeiro a sofrer.

A Nvidia não precisa perder o trono para perder poder. Ela só precisa deixar de ser inevitável.

A parte difícil que quase todo mundo subestima

A história seria fácil se bastasse “rodar PyTorch na TPU” e pronto. Não é assim. Construir paridade prática com CUDA em ambientes corporativos é o tipo de trabalho ingrato que exige anos de engenharia, testes e acertos finos. A própria existência de discussões públicas sobre tornar o backend mais “nativo” mostra que ainda há estrada pela frente.

Alguns desafios que costumam aparecer nesse tipo de migração, mesmo quando o código do modelo não muda:

  • cobertura completa de operadores e casos de borda,
  • estabilidade e previsibilidade em produção, com observabilidade madura,
  • desempenho consistente em modelos variados, não só em benchmarks “favoráveis”,
  • suporte a treinamento distribuído e inferência em escala com ergonomia de engenharia,
  • ecossistema ao redor, como quantização, kernels customizados, serving, compilação, profiling.

O detalhe é que essa lista não precisa ficar perfeita para ameaçar o lock-in. Ela precisa ficar boa o suficiente em um subconjunto valioso, por exemplo, inferência massiva de modelos populares, ou treinamento de certas famílias de arquitetura. Em infraestrutura, atacar um pedaço muito caro do custo já é suficiente para criar “saídas” na fortaleza.

E a Nvidia, fica parada?

Seria estranho imaginar a Nvidia olhando isso de braços cruzados. Ela tem recursos, talento e uma vantagem real: maturidade de ecossistema, ferramental e rede de parceiros.

O que tende a acontecer, como dinâmica de mercado, é uma corrida em duas frentes:

  1. A Nvidia reforça o valor do seu ecossistema, com melhores ferramentas, melhor performance, melhores bibliotecas, mais integração com frameworks, mais facilidades que façam o custo de ficar parecer ainda menor.
  2. O resto do mercado tenta reduzir o custo de sair, criando caminhos compatíveis, “nativos”, que façam a troca parecer só uma decisão de infraestrutura.

O segundo ponto é exatamente o que torna TorchTPU interessante, e por que a participação da Meta é um multiplicador, não um detalhe.

O cenário mais plausível, se essa peça encaixar

Em vez de imaginar um “colapso” da Nvidia, a visão mais realista é um deslocamento gradual do centro de gravidade:

  • no começo, TPUs viram alternativa crível para alguns workloads, principalmente onde custo por inferência pesa mais que qualquer outra coisa,
  • depois, empresas começam a adotar postura multi fornecedor, mesmo mantendo Nvidia como base,
  • com o tempo, a pressão competitiva aparece em preços, prazos e contratos, antes de aparecer em manchetes dramáticas.

Esse é o tipo de mudança que, vista de perto, parece lenta. Vista de longe, parece inevitável.

Uma última observação, que vale ouro para não cair em torcida: nada disso é destino. É uma hipótese de engenharia e mercado. Se o TorchTPU virar uma integração meia boca, se a experiência continuar “especial”, se o desempenho for inconsistente, se o suporte corporativo for frágil, a Nvidia segue com o fosso cheio de crocodilos. Se o TorchTPU entregar uma experiência realmente banal, previsível e eficiente, aquela palavra que sustenta impérios, inevitável, começa a perder o sentido.


Referências

Exclusive: Google works to erode Nvidia's software advantage with Meta's help https://www.reuters.com/business/google-works-erode-nvidias-software-advantage-with-metas-help-2025-12-17/

Cloud Tensor Processing Units (Cloud TPUs) https://cloud.google.com/tpu

PyTorch/XLA https://github.com/pytorch/xla

Evolving PyTorch/XLA for a more native experience on TPU https://github.com/pytorch/xla/issues/9684

Cloud TPU release notes https://docs.cloud.google.com/tpu/docs/release-notes

Meta and Google could be about to sign a mega AI chip deal - and it could change everything in the tech space https://www.techradar.com/pro/meta-and-google-could-be-about-to-sign-a-mega-ai-chip-deal-and-it-could-change-everything-in-the-tech-space